Servir un modèle de langage ne consiste pas seulement à générer des tokens : cela se mesure, se planifie et s’optimise. Entre calcul, bande passante et mémoire, pré-remplissage et décodage n’ont pas les mêmes contraintes. Quantification, FlashAttention et gestion du cache KV figurent parmi les outils pour réduire la latence et augmenter le débit.
Quantifier, optimiser l’attention et mieux batcher pour gagner en vitesse
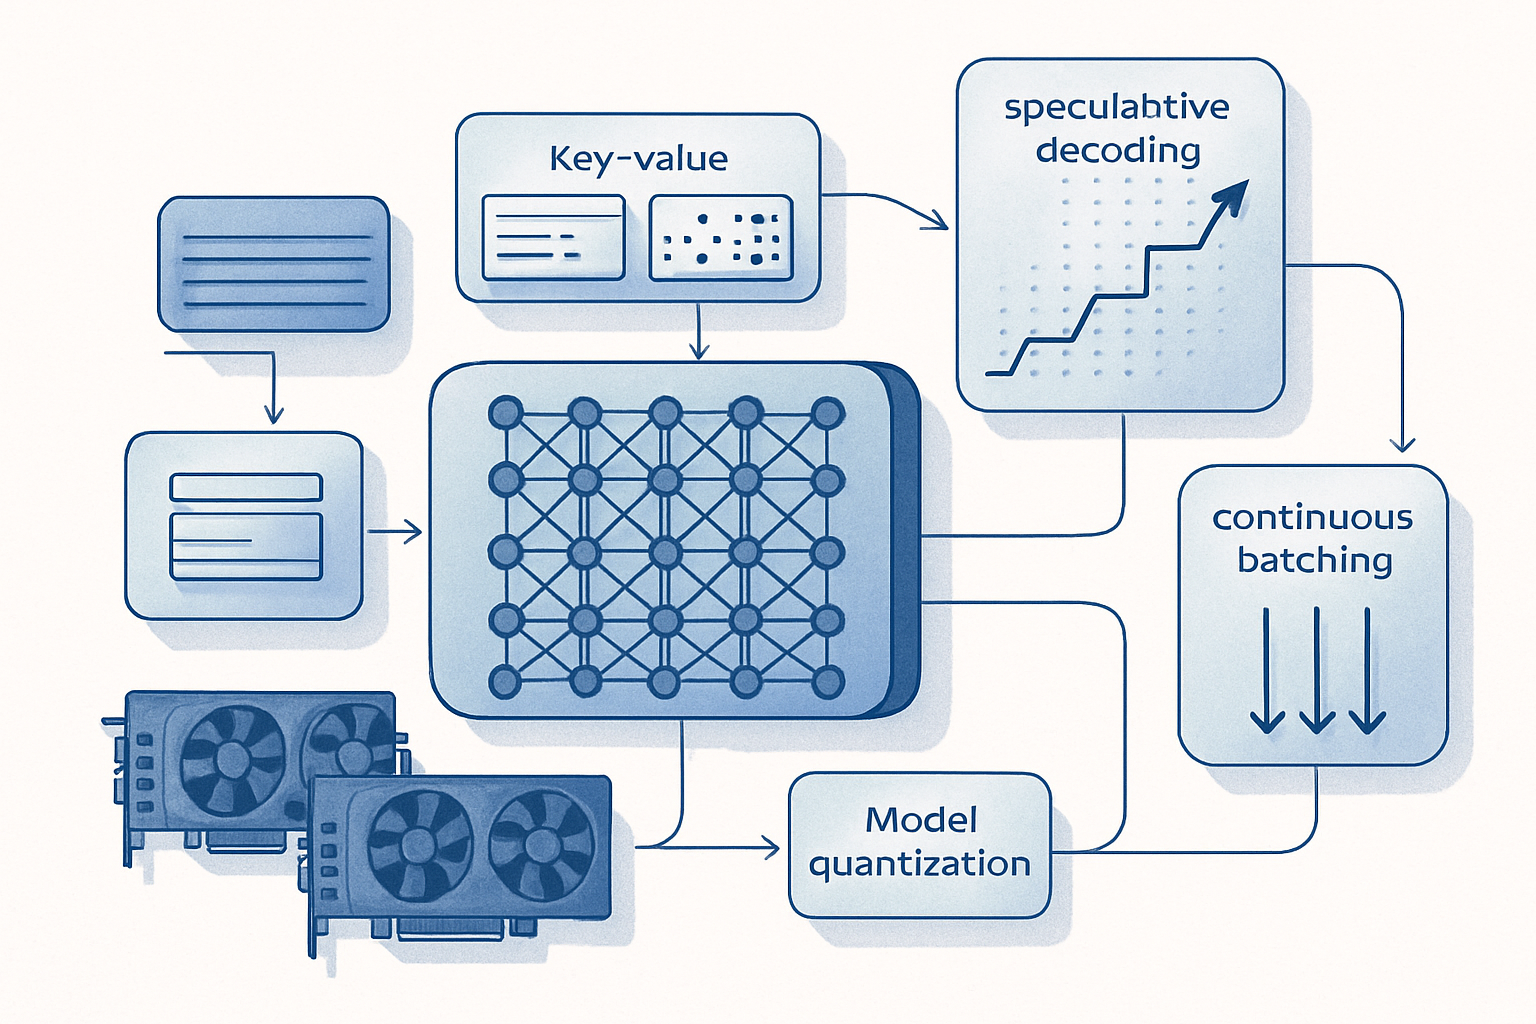
Plusieurs leviers d’optimisation ciblent des limites différentes de l’inférence. La quantification consiste à représenter les poids ou activations du modèle avec une précision numérique réduite. Pour un modèle de 8 milliards de paramètres, les poids occupent environ 32 Go en FP32, 16 Go en FP16 ou BF16, 8 Go en INT8 et 4 Go en 4 bits, hors métadonnées, mémoire cache et frais d’exécution. Cette réduction peut permettre l’exécution sur des matériels plus petits et diminuer la bande passante mémoire, au prix d’une possible baisse d’exactitude et avec des gains dépendant du matériel et de l’implémentation. Concernant l’attention, les implémentations classiques déplacent des tenseurs intermédiaires coûteux entre la mémoire GPU et le stockage sur puce. FlashAttention améliore l’efficacité en traitant l’attention par blocs avec du tiling, évite de matérialiser la matrice d’attention complète en mémoire à large bande et préserve les résultats d’attention exacts à des différences numériques près. Enfin, le batching fixe traditionnel regroupe les requêtes mais souffre d’inefficacités lorsque les durées divergent ; les moteurs modernes optimisent séparément pré-remplissage et décodage pour mieux s’adapter à ces profils.
Mesurer l’inférence : TTFT, TPOT, débit et queues longues
Avant d’optimiser, il faut observer les bons indicateurs. Le TTFT mesure le délai jusqu’au premier token, en incluant la mise en file d’attente, le pré-remplissage et le décodage initial. Le TPOT quantifie l’intervalle moyen entre tokens après le premier. Le débit rend compte du volume total servi dans le temps, pouvant rester élevé même si les utilisateurs reçoivent des tokens plus lentement. En complément des moyennes, les latences p95 et p99 sont nécessaires pour repérer des requêtes lentes. Des mesures spécifiques par étape sont aussi importantes : temps de pré-remplissage et temps par token de sortie.
Mémoire et concurrence : le cache KV devient central
Le cache clé-valeur, réutilisé au décodage pour éviter de recalculer l’historique, permet d’économiser du calcul mais augmente la consommation mémoire. Sa taille croît avec la longueur du contexte, et servir plusieurs utilisateurs simultanément accentue cette pression, faisant de sa gestion un élément clé d’un service efficace. En décodage, l’accès répété aux poids et au cache se heurte à la bande passante mémoire ; pour de petits batchs, le transfert de données peut prendre plus de temps que le calcul lui-même. Une capacité de calcul accrue ne garantit pas une génération proportionnellement plus rapide. Sous charge concurrente, la planification des requêtes, la gestion des caches et l’allocation mémoire deviennent critiques, ce qui justifie l’existence de moteurs spécialisés.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Les performances varient selon le calcul GPU et la gestion mémoire
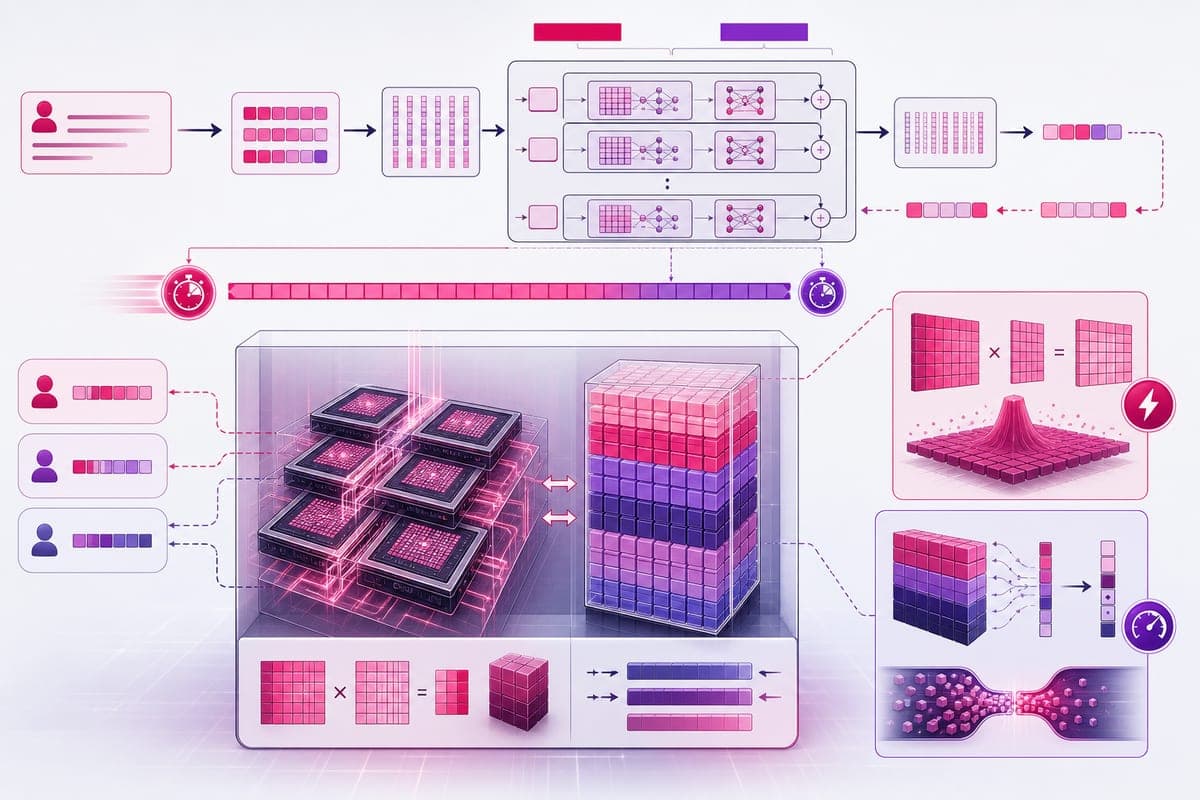
Les performances dépendent à la fois du calcul GPU, de la bande passante mémoire, de la VRAM, de la longueur de contexte et de l’efficacité de la planification. Le pré-remplissage repose sur de grandes multiplications matricielles et rencontre surtout des limites de calcul. Le décodage est plus souvent contraint par la bande passante mémoire. Les invites longues intensifient l’attention et augmentent la taille du cache, un phénomène courant dans les usages RAG, l’analyse de documents ou les assistants de codage, où les entrées comptent régulièrement des milliers de tokens.
Une requête suit plusieurs étapes de conversion et de traitement
Une requête passe par plusieurs étapes. Le texte est d’abord converti en identifiants numériques par le tokenizer, puis transformé en embeddings pour le transformer. En pré-remplissage, l’invite traverse les couches du modèle, potentiellement en parallèle sur de nombreuses positions, et initialise le cache clé-valeur. Cette phase implique d’importantes opérations matricielles et du calcul intensif. Ensuite, le modèle génère des tokens de sortie séquentiellement : à chaque étape, il doit choisir un token sans disposer du contexte futur, en ne recalculant que les informations d’attention du nouveau token et en s’appuyant sur le cache existant pour l’historique.
Ce que fait — et ne fait pas — l’inférence
L’inférence exploite un modèle entraîné, dont les milliards de paramètres appris restent figés, pour prédire le prochain token à partir de l’entrée et du contexte déjà généré. La génération progresse token par token selon une stratégie de décodage, sans rétropropagation ni mise à jour de gradient. Sans cache, les représentations passées devraient être recalculées à chaque pas. Dans l’attention, chaque token est projeté en Q, K, V, base du mécanisme réutilisé au décodage. Les principaux enjeux sont la vitesse de réponse, la mémoire GPU, le débit et les coûts d’exploitation. Le pré-remplissage est particulièrement déterminant sur les longs documents et le RAG, tandis que le décodage pèse fortement pour les chatbots et la génération de code.