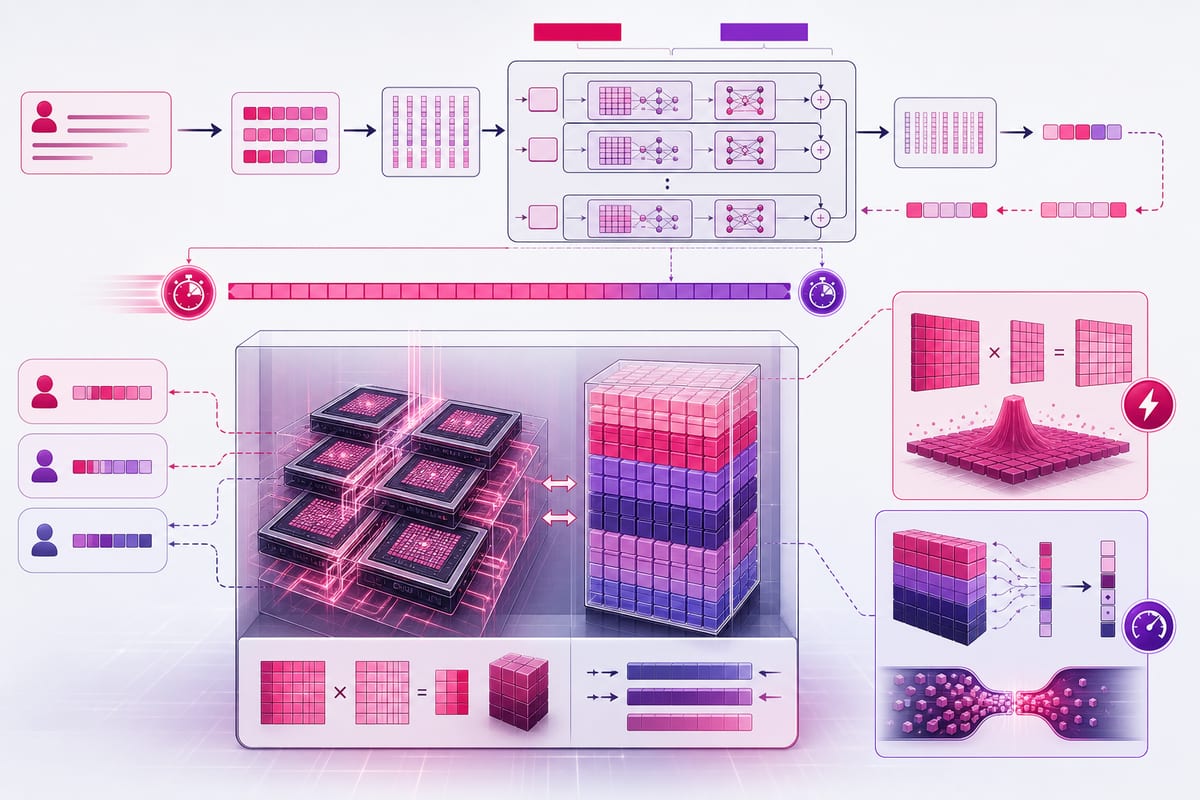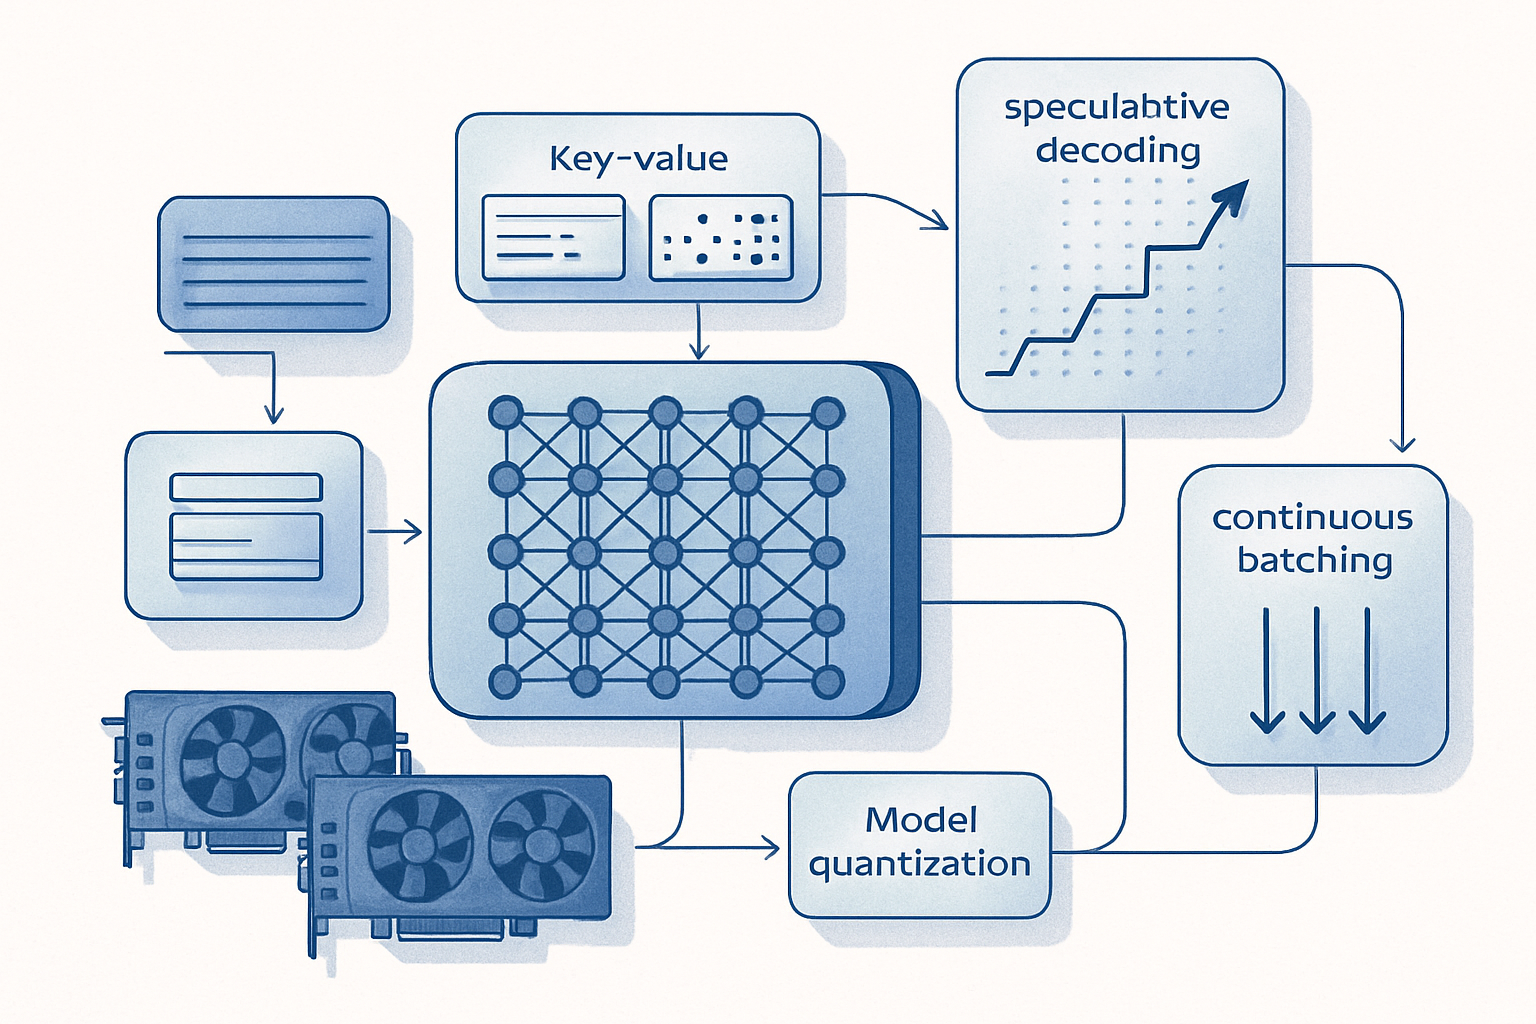
Compression de modèle, cache de préfixe, batching en vol, PagedAttention, décodage spéculatif ou séparation pré-remplissage/décodage : chaque levier répond à un symptôme précis. Un cadre en six questions oriente le choix et explicite les coûts et limites, de la latence inter-token aux contraintes mémoire GPU.
Ce que chaque levier coûte et ce pour quoi il est fait
Les techniques de compression comme la quantification, la sparsité et la distillation entraînent une perte de précision, et il est plus difficile d’obtenir des activations quantifiées correctes que des poids quantifiés. La mise en cache de préfixe échoue dès qu’il existe une différence, même minime, dans le préfixe partagé. Le batching continu présente peu d’inconvénients et dépend surtout de son activation. PagedAttention ajoute une couche de table de pages au calcul d’attention. Le décodage spéculatif est adapté à la génération sensible à la latence pour un utilisateur unique, mais il n’est rentable qu’avec un taux d’acceptation suffisamment élevé. La désagrégation pré-remplissage-décodage cible les trafics où pré-remplissage et décodage se disputent le même GPU, avec un coût réseau pour déplacer le cache KV et une complexité de routage supplémentaire. Le parallélisme tensoriel ou de pipeline peut entraîner des bulles de pipeline et une surcharge de communication entre appareils. Le déchargement du cache KV s’adresse aux contextes longs ou à forte concurrence qui manquent de mémoire GPU, au prix d’une latence lors de la récupération. Enfin, l’inférence par lots hors ligne maximise le débit mais ne convient pas aux cas où un temps de réponse strict est requis.
Reconnaître les signaux d’échec et premiers correctifs
Lorsque le taux de réussite du cache de préfixe reste très faible malgré des prompts identiques envoyés plusieurs fois, cela révèle généralement une absence de déterminisme dans la sérialisation ou la présence de contenu dynamique inséré trop tôt dans le prompt. Pour corriger ce problème, il convient de placer d’abord le contenu statique et de réorganiser l’ordre des clés dans le contexte sérialisé. Si la taille de lot demeure inchangée alors que la mémoire disponible n’est pas saturée, cela peut signifier que PagedAttention n’est pas activé ou que la taille de page n’est pas correctement paramétrée. La plupart des moteurs modernes prennent déjà en charge PagedAttention et activent le batching continu par défaut, ce qui justifie de vérifier ces réglages avant d’ajouter de la complexité.
Quand réduire le modèle avant tout le reste
Si le modèle occupe presque toute la mémoire GPU, l’espace disponible pour le cache KV devient très limité et la taille de lot se retrouve contrainte, indépendamment du planificateur utilisé. Lorsque le modèle est trop volumineux ou que l’inférence, avec une taille de lot d’une seule requête, est bridée par la puissance de calcul, il est recommandé de commencer par appliquer des méthodes de compression sur le modèle. La quantification consiste à diminuer la précision des poids et des activations, la sparsité structurée supprime certains poids jugés moins importants afin de réduire les calculs, et la distillation revient à former un modèle plus compact pour reproduire le comportement d’un modèle plus grand. Ces différentes méthodes, qui restent largement indépendantes de la pile logicielle utilisée, fixent la capacité matérielle restante.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Exploiter la répétition des prompts et l’arrivée en vagues
Dans les applications de chat, l’historique complet est transmis à chaque échange, les frameworks d’agents emploient massivement un même prompt système et les pipelines RAG utilisent fréquemment les mêmes instructions en amont. Lorsque qu’une portion importante du trafic utilise un préfixe identique, la mise en cache de préfixe s’avère la méthode la plus efficace, car elle permet d’éviter de recalculer le cache KV pour des tokens déjà vus, avec des bénéfices qui augmentent à mesure que les conversations s’allongent. Cette technique ne fonctionne que si le préfixe partagé correspond exactement caractère par caractère, d’où l’intérêt de placer le contenu stable au début et le variable à la fin du prompt. Si les prompts sont surtout uniques, la variabilité des longueurs de réponse devient le sujet. Un chatbot de support peut produire une phrase alors qu’un assistant de code peut générer quatre cents lignes, et sous batching naïf tout le lot attend la requête la plus lente. Le batching continu corrige ce temps d’inactivité en retirant immédiatement les séquences terminées et en admettant de nouvelles requêtes sans attendre une limite de lot, une option généralement activée par défaut.
Mémoire du cache KV : fragmentation et allocation
Quand le trafic est bien groupé mais que la mémoire limite la taille de lot, la gestion du cache KV peut être en cause. Certains moteurs réservent par requête un bloc de mémoire contigu dimensionné pour la séquence maximale, ce qui laisse de larges portions inutilisées et bloque d’autres requêtes. PagedAttention répond à ce problème en découpant le cache en pages de taille fixe et en autorisant des allocations en plus petits morceaux. La plupart des moteurs modernes le supportent et il faut vérifier son activation avant de complexifier l’architecture. Si la mémoire n’est pas le facteur limitant, la latence de décodage par token devient la priorité suivante.
Latence inter-token ou contention GPU : deux chemins distincts
Pour accélérer le streaming de tokens utilisateur par utilisateur, le décodage spéculatif utilise un modèle de brouillon qui propose plusieurs tokens, vérifiés en un seul passage par le modèle principal. Lorsque ces propositions sont correctes, plusieurs étapes séquentielles sont validées ensemble, ce qui réduit la latence inter-token. Ce mécanisme introduit toutefois le coût d’un modèle supplémentaire et d’une vérification, et il n’est pertinent que si le modèle de brouillon est adapté et le taux d’acceptation suffisant. À grande échelle, une autre préoccupation est la concurrence entre pré-remplissage et décodage sur le même GPU : des pré-remplissages longs peuvent retarder le décodage. La désagrégation sépare ces phases sur du matériel dédié, les nœuds de pré-remplissage passant le cache KV à des nœuds de décodage optimisés. Cette séparation ajoute un coût de transfert et de routage qui n’a de sens que si le trafic le justifie. Pour des volumes plus faibles ou pour des traitements non interactifs, l’inférence par lots réalisée hors ligne s’avère souvent plus aisée. En l’absence de conditions spécifiques, il est préférable de commencer par le batching continu et la mise en cache de préfixe.
Le cadre décisionnel en six étapes et ses hypothèses
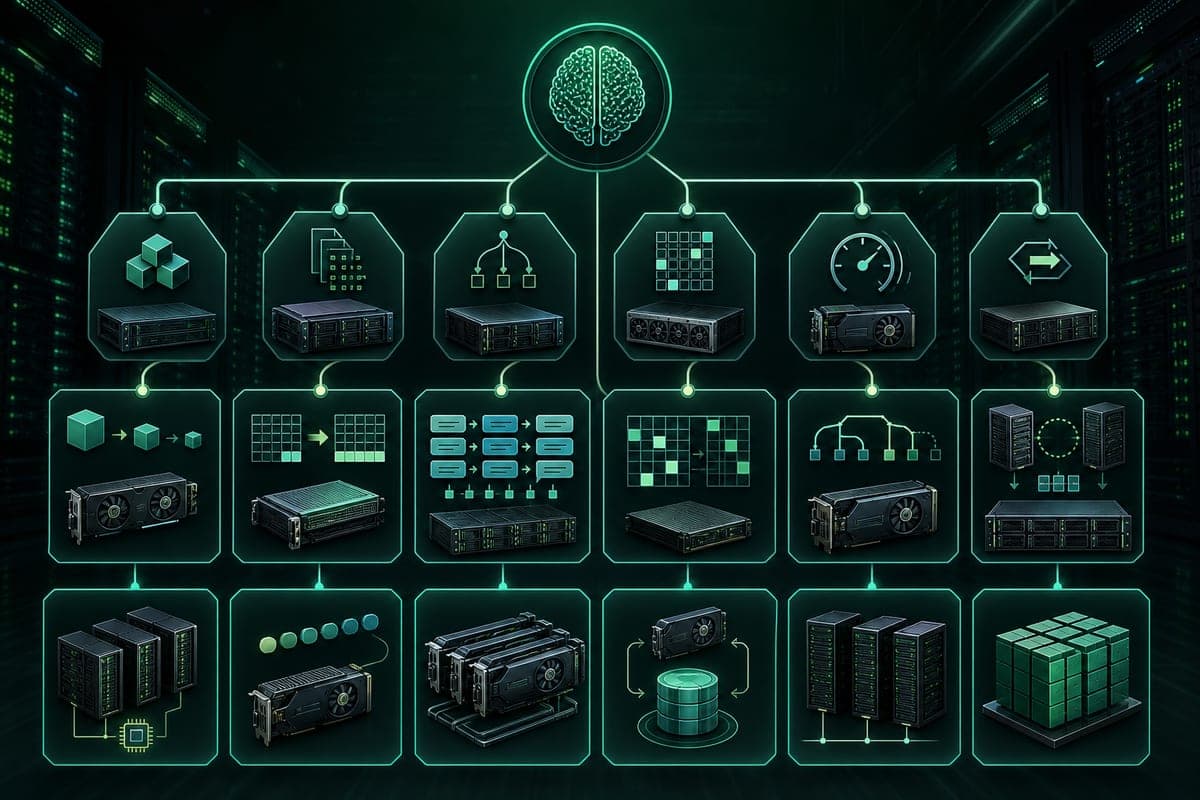
Le choix d’une optimisation s’organise autour de six questions qui testent successivement la taille effective du modèle face au matériel, l’existence d’un préfixe de prompt récurrent, la présence d’arrivées simultanées avec sorties variables, la fragmentation ou la sur-provision du cache KV, la priorité donnée à la latence de décodage par token, puis la contention entre pré-remplissage et décodage sur un même GPU. Chaque technique s’appuie sur une hypothèse explicite : compression si le modèle est trop grand pour le matériel ou la latence visée, mise en cache si les prompts partagent un préfixe, batching continu si les longueurs varient, PagedAttention si la mémoire KV bloque, décodage spéculatif si le goulet est le décodage, désagrégation si les phases se concurrencent, parallélisme si le modèle ne tient pas sur un seul appareil, déchargement de KV si la mémoire GPU manque, et lots hors ligne si l’interactivité n’est pas requise.