Google présente deux nouvelles variantes de ses TPU de 8e génération. La 8tx cible l'entraînement et l'inférence confidentiels avec sécurité matérielle, tandis que la 8i Max double mémoire, calcul et bande passante de la 8i. Ces lancements interviennent alors que les hyperscalers développent leurs propres puces pour réduire leur dépendance à Nvidia.
Les géants du cloud conçoivent leurs puces, Nvidia sous pression
Microsoft, Amazon, OpenAI et Anthropic développent leurs propres semi-conducteurs dédiés à l'IA et les logiciels associés afin de réduire leur dépendance à Nvidia. Google renforce également sa stratégie de fabrication de puces pour limiter l'utilisation de composants externes dans son activité cloud. Cette dynamique s'inscrit dans un contexte où Nvidia traverse une période délicate, après que son PDG Jensen Huang a reconnu avoir eu une liaison avec une personne soupçonnée d'espionnage pour la Chine.
TPU 8tx : entraînement et inférence confidentiels avec AMD
La TPU 8tx, conçue en collaboration avec AMD et basée sur la TPU 8t, fait partie de la huitième génération de puces introduite en avril. Google indique que cette puce est destinée à l'entraînement et à l'exécution de modèles d'IA de façon confidentielle. La sécurité est intégrée directement dans la couche matérielle afin de protéger et d'isoler les données sensibles et les poids des modèles, même pendant leur utilisation. La TPU 8tx dispose d'un réseau d'inférence personnalisé qui permet d'effectuer des raisonnements en parallèle de l'entraînement, ce qui autorise la distillation et l'entraînement de petits modèles à la volée. Selon Google, cette capacité peut être utile pour entraîner un modèle sur des données propriétaires sans avoir à transférer ces données entre différents appareils.
Vous suivez la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
TPU 8i Max : mémoire et débit doublés pour l’inférence
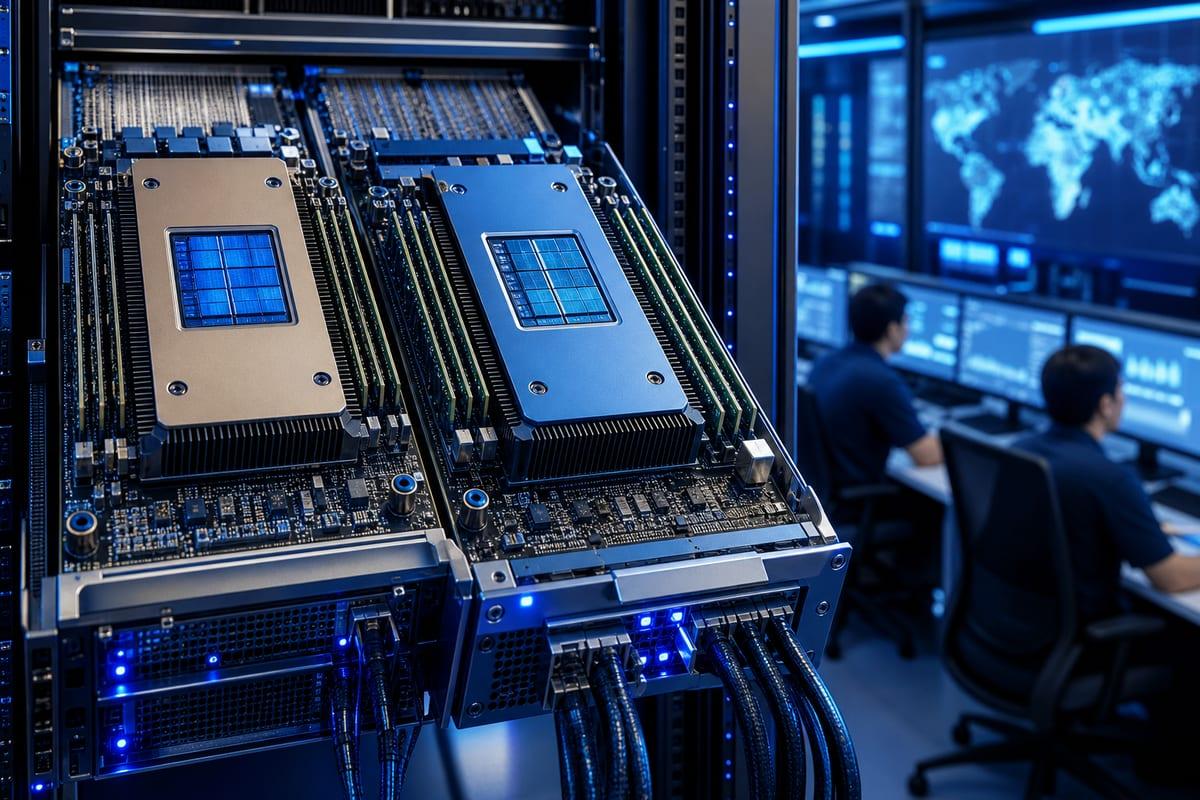
La TPU 8i Max regroupe deux puces TPU 8i axées sur l'inférence, lancées en avril, dans un seul composant. Cette configuration double la capacité mémoire, la puissance de traitement et la bande passante par rapport à une TPU 8i, permettant ainsi aux modèles d'IA de traiter une gamme plus large d'informations lors des requêtes. Google a présenté ces variantes de la huitième génération de TPU pour répondre à la fois aux besoins d'inférence confidentielle et à ceux de charges de travail nécessitant une mémoire accrue.