Tu suis la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
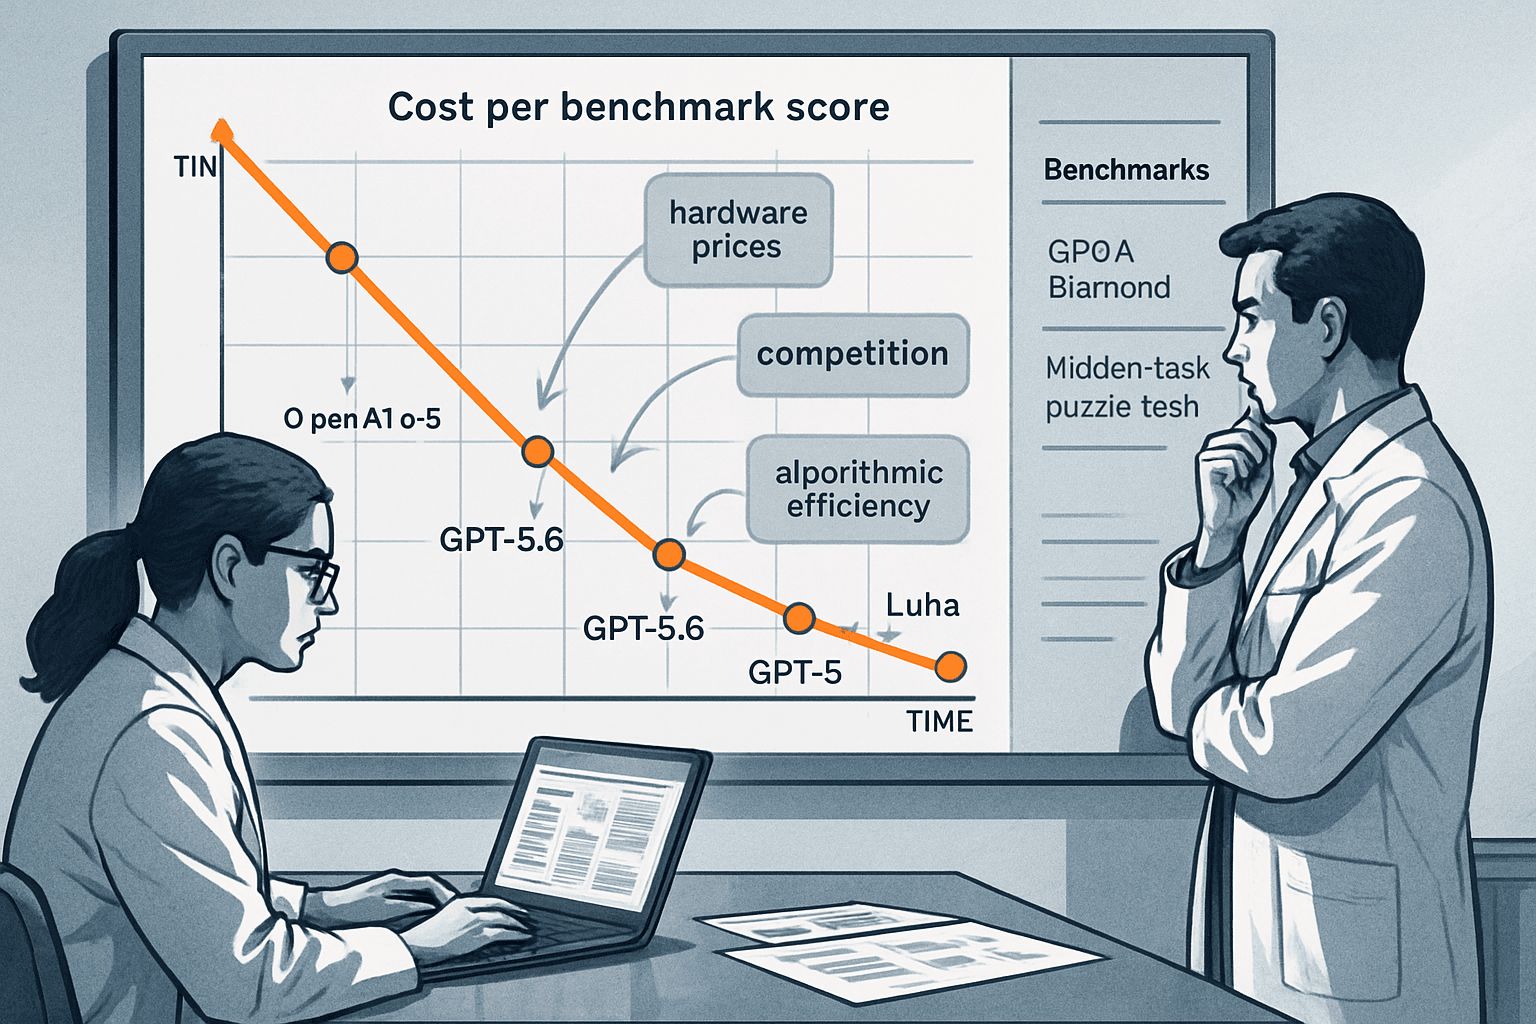
Les prix facturés pour atteindre un score identique sur des benchmarks d’IA diminuent fortement. Epoch AI évoque une baisse moyenne de 47 % par trimestre, tandis que des chercheurs du MIT estiment une diminution annuelle de 5 à 10 fois et un gain algorithmique d’environ 3 fois. Des exemples récents et plusieurs garde-fous méthodologiques nuancent la lecture de ces chiffres.
Des progrès de score qui peuvent coûter plus cher à exécuter
Le MIT observe que certains gains sur des benchmarks proviennent d’une utilisation accrue des ressources de calcul, et non d’une efficacité intrinsèque. Sur le GPQA Diamond, une part de l’amélioration d’un nouveau modèle sur son prédécesseur vient d’un surcroît de puissance allouée par question, ce qui accroît le score mais renchérit l’exécution. Des tests de codage et de mathématiques montrent une version atténuée du même mécanisme. Tous les progrès mesurés ne se convertissent donc pas en gains d’efficacité. Les performances agrègent en réalité entraînement, données, architecture et calcul en temps de test, si bien qu’un score unique mélange ces dimensions.
Benchmarks et effets de bord : benchmaxxing et test secret
L’optimisation ciblée de tests connus, ou benchmaxxing, peut gonfler des scores sans bénéfice clair. Pour atténuer ce biais, Epoch AI inclut Mystery Game Puzzles, un test fondé sur un jeu tenu secret. Les coûts y diminuent le plus lentement, ce qui est cohérent avec l’hypothèse d’optimisation des benchmarks, même si le format des tâches ou le bruit statistique peuvent aussi expliquer cet écart.
Deux lectures de la baisse : 47 % par trimestre ou 5 à 10 fois par an
Epoch AI estime que les coûts pour un score donné reculent d’environ 47 % par trimestre, soit environ 13 fois par an, et soutient qu’aucun autre secteur technologique transformateur n’a connu une contraction comparable. Ces chiffres reflètent les prix de marché pour un score fixe, sans prétendre mesurer directement des gains algorithmiques ou la productivité réelle. Les chercheurs du MIT, s’appuyant sur des données d’Artificial Analysis, évaluent une baisse annuelle de 5 à 10 fois et, une fois isolés l’effet du matériel moins cher et de la concurrence, un gain d’efficacité algorithmique d’environ 3 fois par an. Ils notent aussi que les modèles de raisonnement réaffectent davantage de calcul aux tâches difficiles, ce qui peut accroître le coût par bonne réponse même si le prix par jeton diminue. Selon leur lecture, la différence avec le facteur 13 d’Epoch AI tient au fait que ce dernier n’isole pas matériel et concurrence. La comparaison par jeton reste partielle, les jetons n’étant qu’une unité de facturation.
Cas concret : du score d’o3 à la famille GPT-5.6
Au début de l’année 2025, o3 d’OpenAI a obtenu 75 % au GPQA Diamond, avec un coût par question évalué à 30 cents. Dix-huit mois après cette performance, un modèle issu de la gamme GPT-5.6 a atteint ce même résultat pour un prix de quatre centièmes de cent de dollar, ce qui représente, d’après Epoch AI, 1/725 du tarif initial. Pour illustrer l’importance de cette évolution, l’organisation compare ce changement à celui d’une voiture dont le prix passerait de 50 000 euros à 70 euros. Selon Epoch AI, l’étude repose sur cinq benchmarks portant sur les mathématiques, les sciences et les énigmes logiques, considérés par l’organisation comme des indicateurs raisonnables mais non exhaustifs. Parallèlement, l’équipe du MIT dirigée par Hans Gundlach utilise des jeux de données issus d’Artificial Analysis couvrant la période d’avril 2024 à novembre 2025 et procède à une évaluation plus large de modèles pour chaque test. OpenAI a également lancé récemment GPT-6 Sol et GPT-6 Luna, annoncés comme moins chers, et l’écart de coûts pourrait s’être accru depuis.
Des classements de modèles prennent en compte la qualité et le coût
Des moyennes de coûts calculées sur l’ensemble des usages n’apportent pas de réponse claire pour une application spécifique. Des services comme Artificial Analysis effectuent un classement des modèles en fonction de la qualité, du coût, du temps de latence, de la taille de la fenêtre de contexte et de la rapidité de génération, et il est rare que le modèle le plus économique soit aussi le meilleur sur tous ces aspects. Un modèle peu cher mais dont la latence est importante ne convient pas à un assistant conversationnel devant répondre en temps réel. À l’inverse, un modèle de raisonnement plus puissant peut s’avérer trop lent pour des flux automatisés. Un modèle plus onéreux peut malgré tout réduire la facture s’il donne plus souvent la bonne réponse et évite les réessais. Ces arbitrages n’apparaissent pas dans une simple comparaison de prix par jeton.