Inception lance Mercury 3, un modèle de langage par diffusion annoncé comme bien plus rapide que ses rivaux. Le tarif est temporairement divisé par deux et la disponibilité couvre plusieurs plateformes, mais les gains de performance restent issus de mesures internes non vérifiées.
Tarifs de lancement et accès multi-plateformes
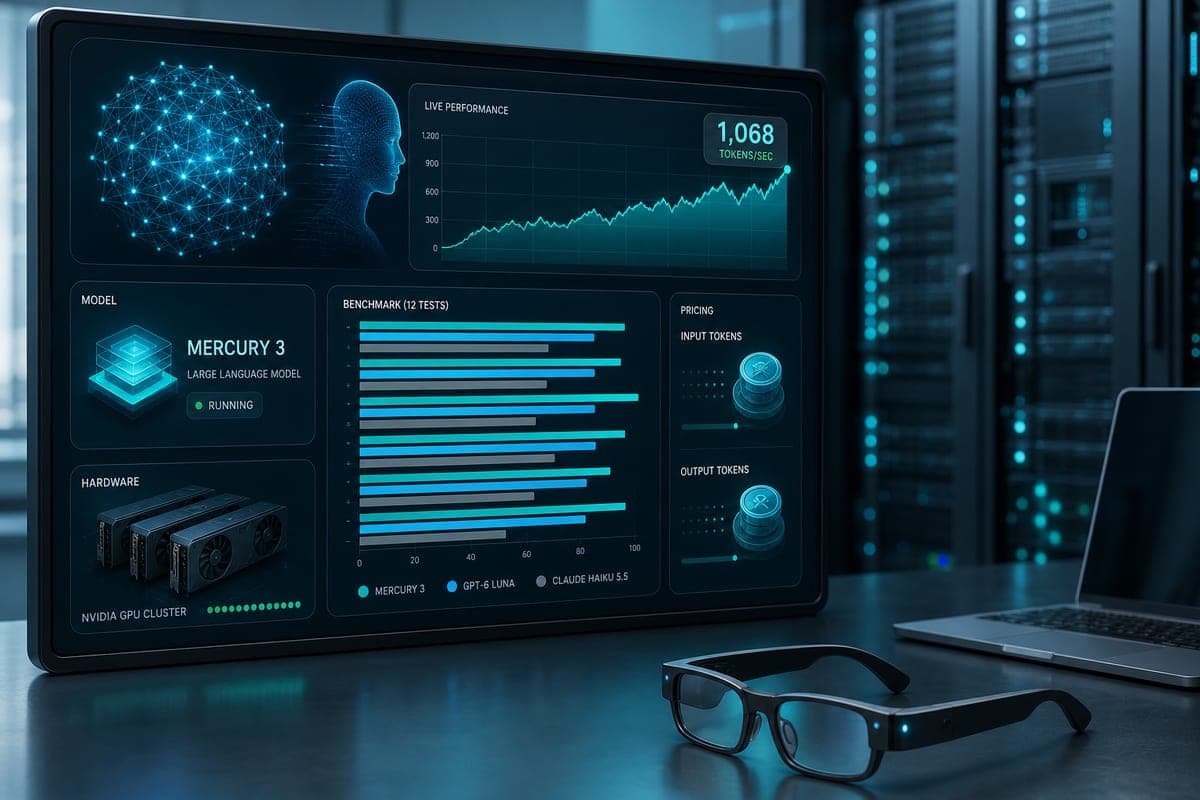
Le tarif standard de Mercury 3 est fixé à 0,20 dollar par million de tokens en entrée et 0,70 dollar par million en sortie. Inception applique une réduction de moitié au lancement, sans indiquer la date de fin de cette remise. Une fois la promotion terminée, le coût de sortie dépasserait celui de GPT-6 Luna et Claude Haiku 5.5 pour les entrées courtes, ces deux modèles facturant 0,50 dollar. Pour les requêtes très longues, ces concurrents deviennent nettement plus chers, alors que Mercury 3 accepte jusqu'à un million de tokens à la fois. Le modèle est accessible sur la plateforme d’Inception ainsi que via OpenRouter, Baseten et Vercel. Il utilise une API compatible avec celle d’OpenAI, et Inception affirme que la migration demanderait peu d’effort aux développeurs.
Vitesse revendiquée et comparaisons sur 12 benchmarks
Inception présente Mercury 3 comme nettement plus rapide que les modèles standards et le décrit comme le modèle de langage par diffusion le plus performant publié. Selon ses mesures internes, Mercury 3 dépasse 1 000 tokens par seconde sur GPU Nvidia et devance GPT-6 Luna et Claude Haiku 5.5 dans huit des douze tests réalisés. L’entreprise revendique une vitesse quatre à huit fois supérieure, avec un débit mesuré à 1 068 tokens par seconde, contre environ 240 pour Claude Haiku 5.5 et 130 pour GPT-6 Luna. Les résultats varient selon les tâches : l’écart est maximal en suivi d’instructions, Mercury 3 obtenant 76,84 points sur IFBench, soit 15 de plus que GPT-6 Luna, et une nette avance sur SWE-Bench Atlas (51,08 contre 33,33 et 32,26). À l’inverse, Claude Haiku 5.5 s’impose sur DeepSWE et pour la recherche d’information dans de longs textes, tandis que GPT-6 Luna prend l’avantage dans deux tests d’Artificial Analysis. Inception résume la qualité de Mercury 3 comme équivalente ou meilleure. Aucun test indépendant ne vient pour l’instant confirmer ces chiffres.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Usages temps réel et retours d’accès anticipé
Mercury 3 est principalement destiné à des applications en temps réel telles que les agents d’IA, la recherche, le support client et le tutorat, où les délais s’additionnent à chaque étape. Des partenaires d’accès anticipé rapportent des améliorations centrées sur la latence. Octen AI, qui développe des fonctions de recherche pour des lunettes intelligentes, estime qu’une réponse en cinq secondes paraît défaillante ; la recherche ne prend qu’environ 80 millisecondes et le modèle de langage constituait le principal goulot d’étranglement. Avec Mercury 3, la réponse médiane serait de 0,9 seconde et le processus complet de 2,2 secondes. General Learning indique fournir des indices et corrections en environ une seconde. Lorikeet rapporte des réponses plus rapides et de meilleurs résultats. Chez TinyFish AI, Shuhao Zhang mentionne 50 tâches de navigation sur sites réels dont 25 résolues par Mercury 3, devant GPT-6.1-Sol, sans chiffre communiqué pour ce dernier.
Choix techniques et trajectoire de la gamme Mercury
Mercury 3 repose sur une génération par diffusion qui commence par une réponse globale puis l’affine en plusieurs passes, contrairement aux modèles générant mot à mot. Inception affirme que Mercury 3 possède plus de 40 fois les paramètres de Mercury 1 tout en conservant la même vitesse, et que les performances ont triplé par rapport à Mercury 1 mini. L’entreprise considère que les modèles de diffusion progressent de façon fiable à mesure qu’ils gagnent en taille, mais ne communique pas le nombre exact de paramètres. En février, Mercury 2 avait été présenté comme le premier modèle de diffusion capable de raisonner via des étapes intermédiaires. Avant ce lancement, Inception avait levé 50 millions de dollars auprès de NVentures, M12 et Snowflake Ventures, les fonds de Nvidia, Microsoft et Snowflake.
Un terrain où Google avance aussi par diffusion
Google développe également des modèles de langage par diffusion. Après une démonstration de Gemini Diffusion, l’entreprise a publié en juin DiffusionGemma en open source. Google affirme que ce modèle fonctionne jusqu’à quatre fois plus vite que Gemma 4 standard, avec des résultats légèrement inférieurs.