Thinking Machines Lab, la startup de Mira Murati, a dévoilé vendredi Inkling 2 Mini, un modèle à poids ouverts capable de fonctionner sur un ordinateur portable. Son architecture répète des calculs internes plutôt que d’expliciter tout son raisonnement, une propriété dont le laboratoire étudie aussi les limites pour la surveillance.
Le raisonnement interne reste difficile à surveiller
Pour contrôler leurs modèles, les laboratoires examinent notamment la chaîne de pensée, c’est-à-dire le raisonnement rédigé. Or les architectures à boucles peuvent effectuer davantage de raisonnement en interne sans l’exposer à un dispositif de surveillance. OpenAI avait exprimé cette préoccupation en septembre, après les très bons résultats d’Astra aux tests. Thinking Machines reconnaît également l’importance de ce raisonnement non écrit pour la surveillance.
Le laboratoire propose une version de recherche dont le nombre de boucles varie de une à cinq, destinée aux expérimentations de tiers. Dans ses essais, cinq boucles ramenaient le raisonnement écrit à 1 661 jetons, contre 3 703 avec une boucle, soit moins de la moitié. Thinking Machines indique que sa lisibilité demeurait identique et que les boucles supplémentaires ne facilitaient pas la dissimulation de sabotages.
Le laboratoire ne constate pas, à cette échelle, de dégradation significative de la surveillance du raisonnement, mais qualifie ses conclusions de préliminaires. Le modèle expérimental n’a reçu un apprentissage par renforcement qu’avec trois boucles ; un entraînement plus poussé pourrait accentuer la compression du raisonnement. Un dispositif limité à l’observation des appels d’outils et des sorties a par ailleurs laissé échapper un nombre significatif d’attaques lors des essais.
Utilisation sur Mac et démonstrations hors ligne
Disponibles sur Hugging Face sous licence Apache 2.0, les poids s’utilisent avec Ollama sur des Mac équipés d’au moins 32 Go de mémoire. Le modèle occupe environ 20 Go et accepte un contexte de 1 million de jetons.
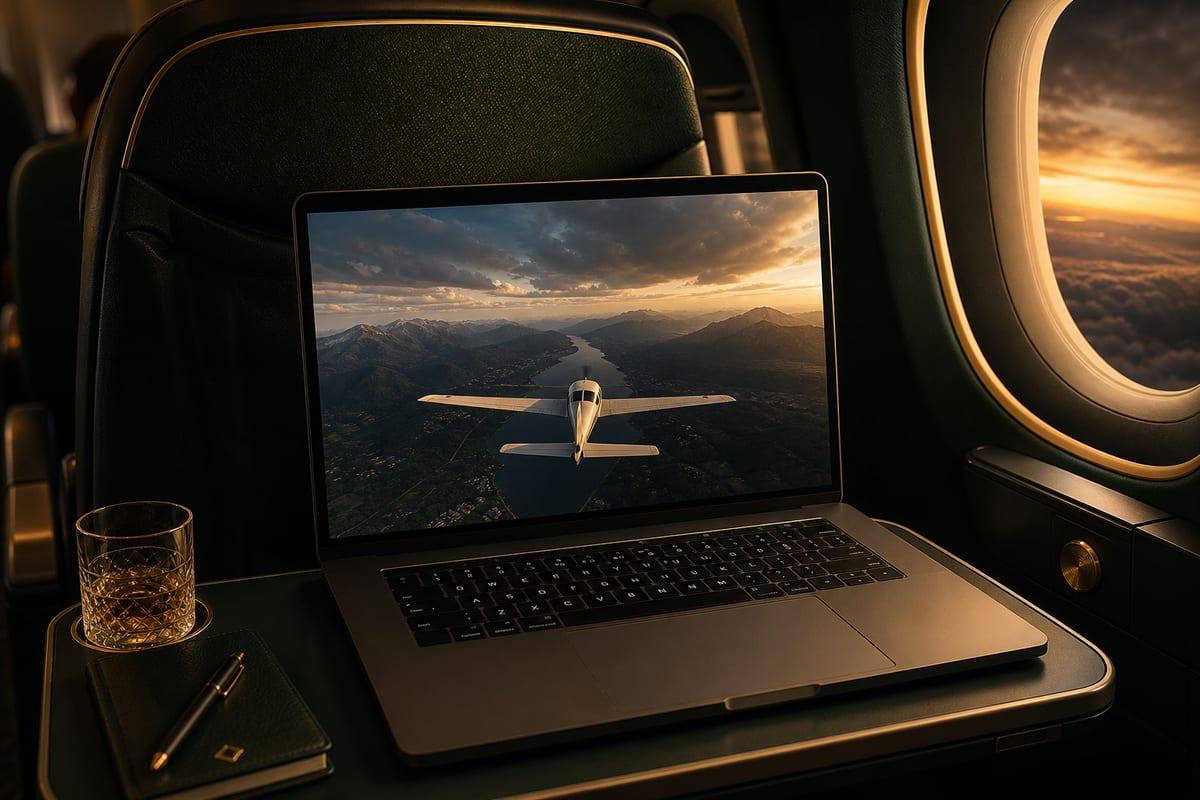
Pour montrer son fonctionnement local, les chercheurs de Thinking Machines ont réalisé une démonstration pendant un vol : sur un MacBook Pro déconnecté, en mode avion, le modèle a produit en quelques minutes un simulateur de vol jouable. Une autre démonstration faisait fonctionner, sur un seul MacBook sans connexion, les 20 villageois d’une ville en pixels qu’il avait lui-même créée.
L’IA créative vous passionne ?
Image, vidéo, son, design génératif : le meilleur chaque soir en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Cette version succède au premier Inkling, lancé en juillet, un très grand modèle ouvert dont Thinking Machines reconnaissait qu’il n’était pas le meilleur. Sur le terrain de l’exécution locale, Flint, développé par Recursive, compte parmi les nouveaux concurrents. Il figure aussi dans les graphiques comparatifs de programmation du laboratoire.
Des tests de programmation aux coûts par tâche
L’organisme indépendant Artificial Analysis place Inkling 2 Mini au 20e rang de son Intelligence Index, au niveau de Qwen3.8 27B, avec environ cinq fois moins de paramètres actifs. Ses mesures donnent un coût de 0,59 $ et une durée de neuf minutes par tâche, contre 3,53 $ et 38,2 minutes pour Qwen3.8 27B. Il décrit ainsi le modèle comme environ six fois moins coûteux et quatre fois plus rapide par tâche. À score égal, Inkling produit toutefois environ 38 % de jetons supplémentaires en sortie ; dans ces mesures, GPT-6 Luna d’OpenAI obtient pour sa part un score de 28 à 0,15 $ par tâche.
Thinking Machines revendique une avance sur tous les modèles à poids ouverts sous les 100 milliards de paramètres dans des tests de programmation tels que DeepSWE. Le laboratoire annonce 48,2 % sur DeepSWE v1.1 et 77,9 % sur une sélection difficile de SWE-bench Pro. Dans sa comparaison, Qwen3.8-27B d’Alibaba atteint respectivement 42,2 % et 73,8 %.
Le laboratoire reconnaît cependant l’avantage de Qwen3.8-27B dans les échanges à plusieurs tours et les consignes cumulant de nombreuses contraintes. Inkling 2 Mini reste aussi derrière de plus grands modèles dans les épreuves de raisonnement difficiles. Selon Thinking Machines, les boucles n’accroissent pas sa capacité à mémoriser des faits.
Les blocs centraux répètent leurs calculs
Inkling 2 Mini repose sur un mélange d’experts : il compte 26,4 milliards de paramètres, dont 3,4 milliards activés pour chaque jeton. Ses 24 couches forment quatre blocs de six : ceux des extrémités passent une fois, tandis que les deux blocs centraux sont exécutés trois fois. Boucles comprises, le total atteint 5,4 milliards d’activations de poids par jeton.
La majorité des poids ont été entraînés puis exécutés directement au format Nvidia NVFP4, sur 4 bits, sans perte liée à une conversion après entraînement. Le laboratoire a également retiré un tiers des experts pendant l’entraînement. Il a ensuite réentraîné le modèle avec 1 000 milliards de jetons issus d’un Inkling interne de plus grande taille.
Selon les essais de Thinking Machines, supprimer les boucles réduisait le coût d’entraînement de 7,5 %. Mais cette variante demandait ensuite 140 % de calcul supplémentaire à l’exécution pour atteindre les performances de la version à boucles.