La recherche en IA te passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
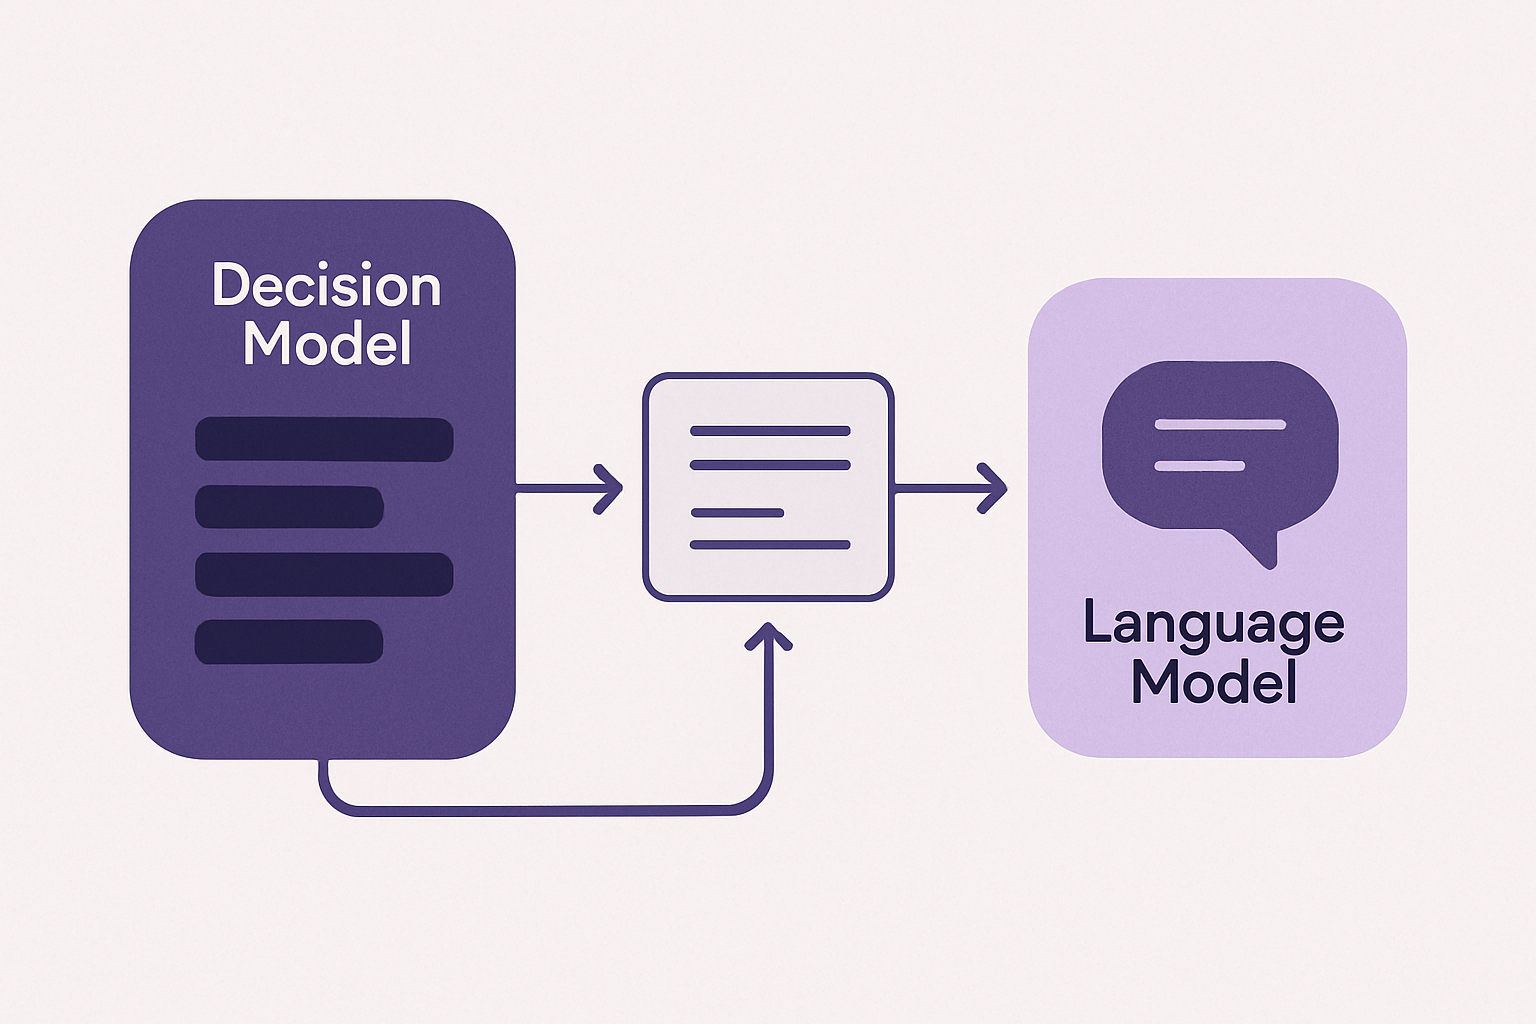
TypeSafe AI met sur le marché Jev, un modèle de « Système Un » qui rend des décisions parmi des options définies et fournit des probabilités. Des tests externes rapportent une bonne calibration de sa confiance et des gains de latence dans certains cas, mais soulignent l’importance cruciale du schéma de réponse. Le modèle se distingue aussi par une facturation limitée aux jetons d’entrée.
Confiance mesurée et pièges de conception révélés par des tests
Un benchmark japonais daté du 18 septembre 2026 rapporte que quatre modèles de chat affichaient une erreur de confiance comprise entre 0,078 et 0,163 sur une échelle de 0 à 1, quand Jev se situait entre 0,002 et 0,047. Ces mesures portent sur la calibration, c’est‑à‑dire l’écart entre la confiance annoncée et la fréquence réelle des bonnes réponses. Un autre signal vient d’un cas PriorBench où 30 messages ne correspondaient à aucune catégorie prévue : en l’absence d’option explicite pour l’indiquer, Jev a tout de même sélectionné une catégorie à chaque fois, avec une confiance d’au moins 0,99. Ce résultat rappelle qu’un modèle peut parfaitement respecter le format attendu tout en prenant une mauvaise décision si les choix proposés sont incomplets. Il en découle qu’un schéma doit offrir une sortie de non‑correspondance lorsqu’aucune catégorie ne convient, et que les comparaisons issues de benchmarks spécifiques ne doivent pas être généralisées sans prudence.
Une mécanique opposée au décodage autoregressif des LLM
Les modèles de conversation génèrent leurs réponses jeton par jeton en utilisant le décodage autoregressif. À l’inverse, selon TypeSafe, Jev n’emploie pas cette boucle de génération : il évalue l’ensemble des choix autorisés en une seule passe et renvoie simultanément leurs probabilités. Pour des tâches où les réponses possibles sont connues à l’avance, cette approche élimine la génération séquentielle et, une fois l’entrée lue, se traduit par une évaluation directe d’un ensemble fixe d’options.
Questions fermées, schéma contraint et options jusqu’à 255
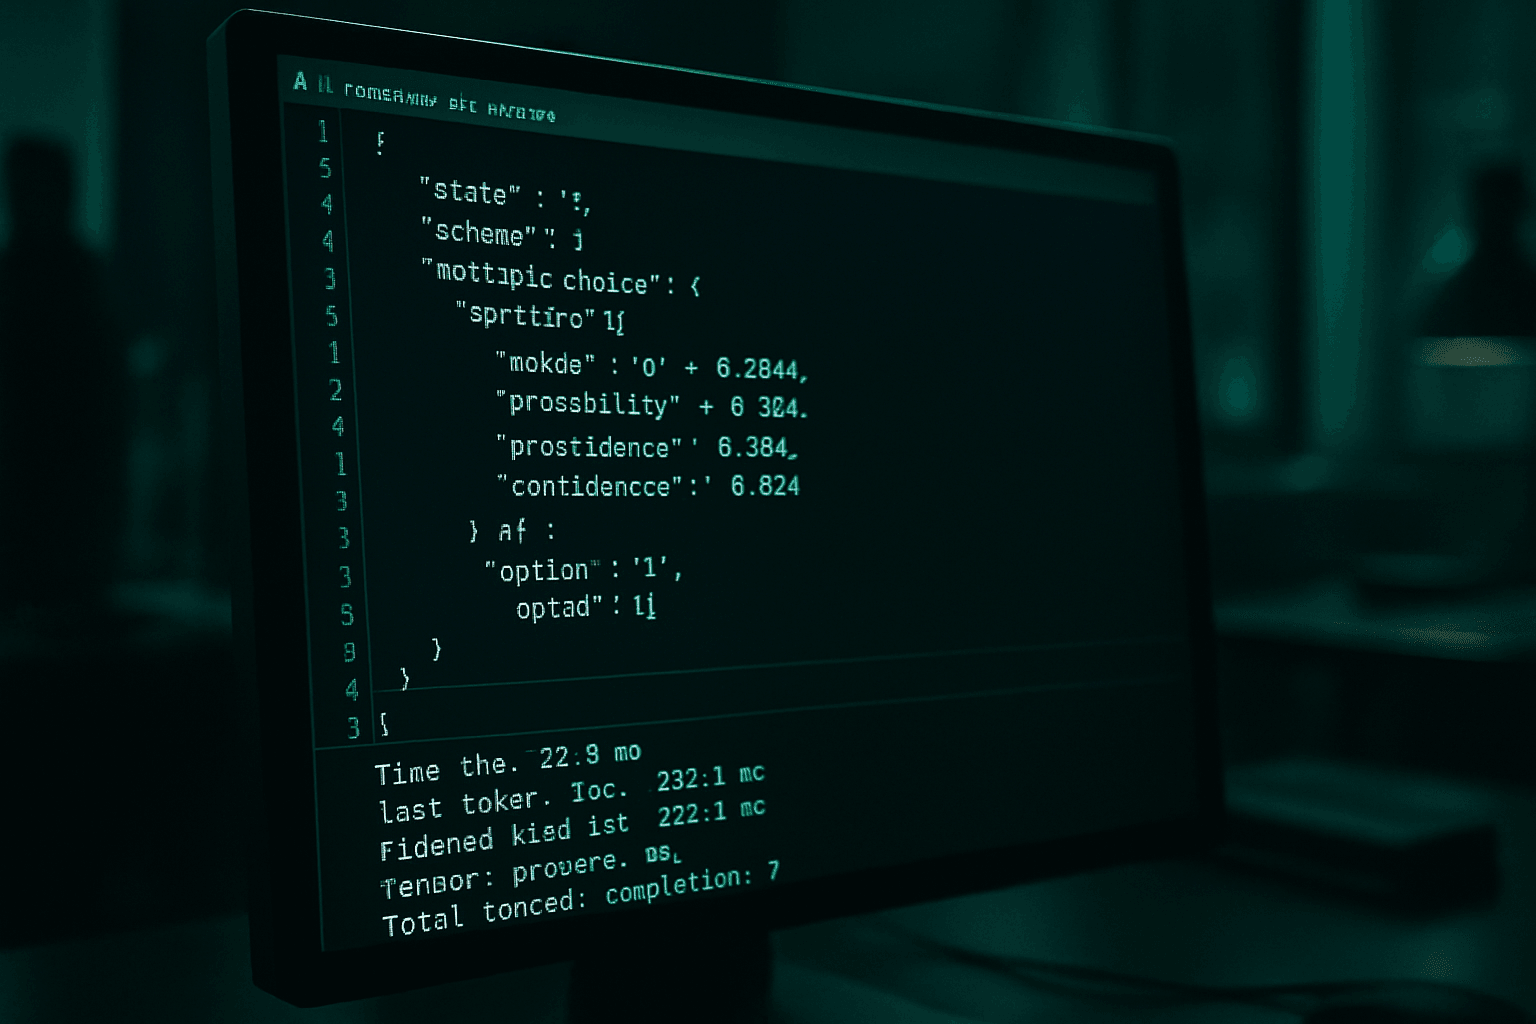
Jev se comporte comme un système à choix multiples : on lui fournit un contexte, une question et la liste des réponses autorisées. Le modèle fournit ensuite une sélection, la probabilité correspondante pour chaque possibilité et un niveau de confiance. Dans l’API, le contexte transmis est désigné comme l’état, et chaque question repose sur un schéma qui précise ce qui constitue une réponse valide. Pour une question fermée, jusqu’à 255 options peuvent être spécifiées, le modèle étant contraint de rester dans cette structure et d’exclure toute option non prévue par le schéma.
Origines intellectuelles et place dans l’écosystème
Le vocabulaire du « Système 1 » et du « Système 2 » provient des travaux de Daniel Kahneman, le premier désignant des jugements rapides et intuitifs et le second une réflexion plus lente et délibérée. Le nom de Jev renvoie à William Stanley Jevons, qui a formulé en 1865 l’idée devenue le paradoxe de Jevons à propos de l’efficacité et de la consommation. Sur le plan technique, des classificateurs de type BERT catégorisent des textes depuis des années, avec des étiquettes généralement figées lors de l’entraînement, tandis que les LLM ont apporté de la souplesse via la sortie JSON et le décodage contraint. Les modèles de « Système Un » cherchent une voie médiane avec des invites flexibles et des sorties prédéfinies. Un modèle ouvert, Laya, a exploré une idée proche en 2025. Après deux ans de développement privé, TypeSafe AI a lancé Jev en septembre 2026. Dans les jours qui ont suivi, des benchmarks indépendants sont apparus, donnant des signaux précoces sur les domaines d’efficacité et la dépendance des résultats à la tâche.
Coûts et performances rapportés, selon les contextes
TypeSafe AI facture uniquement les jetons d’entrée pour Jev, au tarif de 0,042 dollar par million, sans coût associé aux jetons de sortie. Côté performances, un test PriorBench sur 400 éléments créditait Jev de 95,9 % contre 77,2 % pour des règles par mots‑clés. Un test publié par Dan Shipper rapportait une moyenne de 0,35 seconde par vérification pour Jev, contre 8,83 secondes pour Fable 5.1 à effort élevé. Ces résultats dépendent cependant du contexte, la latence variant avec la longueur de l’entrée, le matériel, le réseau et les paramètres de modèle. Jev doit de toute façon lire l’intégralité de l’entrée, ce qui rend les documents longs plus coûteux et plus lents que de brefs messages. La différence majeure se joue ensuite, Jev renvoyant un choix probabilisé parmi des réponses définies plutôt qu’un texte généré.