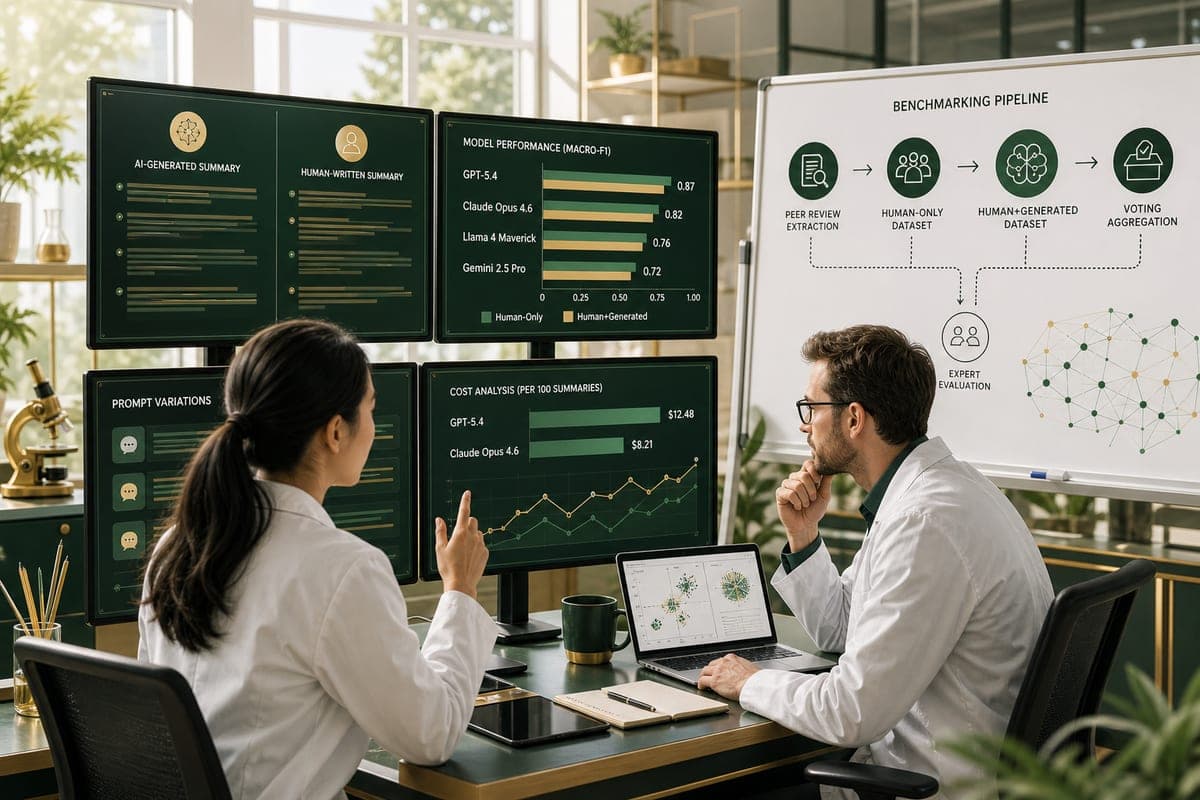
Un benchmark public compare six modèles sur l’évaluation de la nouveauté d’idées scientifiques. Des modifications minimes de prompts inversent des verdicts et font chuter la précision, surtout face à des idées générées par l’IA. Des pipelines spécialisés bien plus chers restent derrière une référence simple. Des données et un outillage complet sont mis à disposition pour reproduire et étendre ces tests.
Des écarts de performance majeurs malgré des coûts élevés
Sur l’ensemble Human+Generated, une configuration de référence avec Claude Opus 4.6, un faible raisonnement et un vote majoritaire sur trois appels atteint 0,854 de macro-F1 pour 2,59 $. Idea Novelty Checker, fondé sur récupération et réévaluation de littérature, obtient 0,642 pour 30,66 $, tandis que Sakana AI's AI Scientist, appuyé sur des recherches itératives dans Semantic Scholar, monte à 0,772 pour 82,05 $. Les deux évaluateurs dédiés utilisaient Claude Opus 4.6 avec un appel par décision. La référence simple est à la fois plus précise et nettement moins onéreuse que ces systèmes spécialisés. Par ailleurs, un juge agentique GPT-5.6 Sol, doté d’un budget de raisonnement très élevé et d’une recherche en direct restreinte à arXiv, atteint 0,78 de macro-F1, contre 0,89 pour Claude Opus 4.6 dans la même comparaison, tout en coûtant environ dix fois plus par décision aux tarifs d’API actuels.
Quelques mots dans un prompt suffisent à retourner des verdicts
La manière de poser la question au modèle concentre l’essentiel des variations observées. Avec GPT-5.4, annoncer qu’une seule idée par paire est réellement novatrice conduit à 93,5 % de précision sur Human+Generated. En retirant cette contrainte et en demandant simplement laquelle est novatrice, la précision tombe à 40,9 % sur les mêmes paires, avec un renversement de verdict pour plus de la moitié des cas. Des chutes de plus de 50 points de pourcentage ont été constatées selon la formulation. Aucun prompt ne s’impose comme supérieur en toutes circonstances : même le retrait d’une instruction visant à exclure les contributions triviales ou incrémentales améliore certains juges et dégrade d’autres.
Idées humaines versus idées générées : stabilité contrastée
Sur des idées rédigées par des humains et assorties d’indices solides sur l’originalité, le passage d’un prompt à l’autre déplace la précision d’environ sept points de pourcentage en moyenne. Dans le détail, Claude Opus 4.6 varie de 21 points sur ce même ensemble. Les juges paraissent ainsi relativement stables sur des textes humains, tout en se montrant beaucoup plus sensibles aux variations de consigne sur des idées générées. Lors de comparaisons entre générateurs, comme Claude Opus 4.5 face à Claude Sonnet 4.5 ou GPT-5.4 face à GPT-5.1, un quart à un tiers des verdicts changent selon le prompt, en moyenne sur six juges.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Comment ont été construits les ensembles de test Human-Only et Human+Generated
Le pipeline d’évaluation s’appuie sur les évaluations ICLR 2026, en extrayant les passages où les rapporteurs discutent explicitement de l’originalité. L’acceptation n’a pas servi de substitut à la nouveauté. L’ensemble à haute nouveauté réunit 154 idées issues d’articles du top 10 % de leur domaine, pour lesquels la nouveauté a été positivement identifiée et jamais contestée par les évaluateurs. L’ensemble à faible nouveauté rassemble 145 idées d’articles rejetés dans le bas 10 %, où des doutes sur l’originalité ont été soulevés sans validation positive. Une vérification séparée a confirmé la polarité du signal de nouveauté dans 47 cas sur 50, les désaccords n’ayant pas modifié l’interprétation. Ces deux ensembles forment Human-Only. Le cadre Human+Generated associe les mêmes 154 idées validées à 154 idées proposées par un générateur LLM basique, sans recherche de littérature, outils, itération ni feedback, avec l’hypothèse d’étiquettes faibles selon laquelle ces idées sont moins novatrices. Un expert a passé en revue 30 paires sélectionnées vers les cas difficiles, préférant à chaque fois l’idée humaine et ne jugeant aucune des idées générées comme novatrice. Les énoncés humains et générés ont aussi été réécrits dans un format commun afin d’écarter un effet de style d’écriture.
Protocole d’essai : comparaisons pointwise et pairwise, facteurs contrôlés
Six juges LLM ont été évalués en comparaisons pointwise et pairwise. Le protocole a varié un facteur à la fois : prompt, budget de raisonnement, accès à des articles connexes, formatage des idées, agrégation de décisions, et modèle générateur pour les idées IA. Des changements apparemment mineurs dans ces paramètres produisent des jugements divergents sur les mêmes contenus. Ni la récupération documentaire ni l’allocation d’un raisonnement supplémentaire ne se traduisent de façon systématique par de meilleurs verdicts. Deux évaluateurs dédiés à la nouveauté ont sous-performé une référence simple, malgré des coûts supérieurs. Tous les juges de la comparaison agentique ont été exécutés une fois par idée sur Human+Generated.
Des outils ouverts pour investiguer un problème encore non résolu
Le projet Old Ideas, Novel Problems s’accompagne d’un benchmark, de données, de code et d’un pipeline automatisé, afin que la communauté puisse répliquer et étendre l’évaluation des juges de nouveauté. Les auteurs indiquent que l’évaluation par LLM de la nouveauté reste instable, en particulier pour les idées générées, et que la fiabilité globale demeure un problème ouvert. L’enjeu est central pour des systèmes d’idéation qui doivent produire des axes véritablement originaux et pour les juges, souvent eux-mêmes des LLM, appelés à arbitrer la distance aux travaux antérieurs. En l’absence de standard de construction et face à l’influence déterminante des choix de configuration, la validation sur des idées humaines seules ne suffit pas. Les outils proposés visent à documenter ces effets et à améliorer la robustesse des pratiques d’évaluation.