La recherche en IA te passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Liquid AI met en ligne deux modèles de décision en « poids ouverts » ciblant des décisions rapides sur appareils NVIDIA. Les latences annoncées tombent sous 50 ms sur Jetson et sous 10 ms sur GPU, avec des réserves sur les benchmarks vision et audio et l’absence de chiffres de vitesse pour la déclinaison omni en recherche.
Latences mesurées et périmètre des chiffres publiés
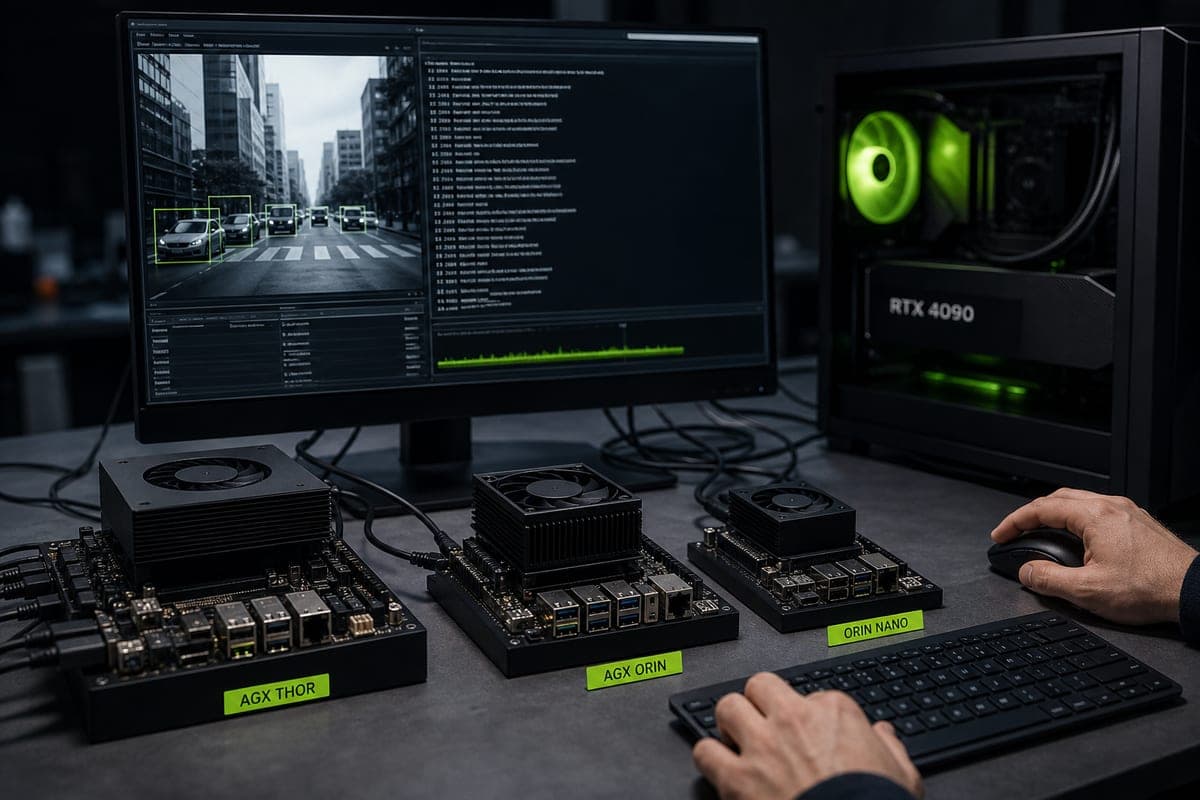
Selon les mesures publiées, d1-3B répond en moins de 50 ms à une question sur chaque appareil edge testé, et trois questions ne prennent que 1.3 fois le temps d’une seule, avec un passage de 16 ms à 20 ms sur AGX Thor. En collaboration avec NVIDIA, l’évaluation a porté sur RTX 4090, Jetson AGX Thor, Jetson AGX Orin 64 Go et Jetson Orin Nano. Sur GPU, d1-3B reste sous 10 ms pour une question et traite une image de 384px en moins de 18 ms, avec un état de 3.4K tokens et 64 états packés. Liquid AI n’inclut toutefois pas de benchmarks de vision ou d’audio, l’Index de Décision v0.3 comportant une séparation de vision privée et les benchmarks audio restant un problème ouvert. Aucun chiffre de vitesse n’est donné pour d1-omni-600M dans cette version en raison de son statut de recherche précoce.
Scores publiés et positionnement des deux modèles
d1-3B affiche un score de 48.57 sur l’Index de Décision 0.2.1, devançant des modèles de 4B et 9B ainsi que Decider 35B-A3B crédité de 47.11. Les deux modèles ont été évalués sur sept jeux publics couvrant compréhension de lecture, toxicité, intentions, médical et interlingual. d1-3B revendique un score moyen de 82.9, présenté comme le plus élevé du tableau et au-dessus de Decider 4B. d1-omni-600M est annoncé à 78.4, supérieur à Decider 2B à 77.1, avec un quart seulement des paramètres rapportés pour ce dernier.
Architecture et modalités annoncées
Les modèles de décision d1 s’appuient sur des Liquid Foundation Models et répondent en un seul passage avant, sans génération de tokens. d1-3B est dérivé de LFM2.5-VL-3B, un modèle visuel uniquement décodeur, et accepte texte et images ; Liquid AI indique qu’il conserve les capacités de vision de ce backbone sur des benchmarks standards. d1-omni-600M est issu de LFM2.5-Encoder-350M, un encodeur bidirectionnel, auquel sont ajoutés des encodeurs pour la vision et l’audio afin de prendre en charge trois modalités, avec des entrées texte+image ou texte+audio ; selon Liquid AI, il est capable de traiter ces trois modalités. Cette version est qualifiée de stade de recherche initial et de développement.
Exécution edge et GPU : conditions de test
Sur Jetson AGX Thor, d1-3B répond en 16 ms ; sur Jetson AGX Orin, en 26 ms ; et sur Jetson Orin Nano, en 50 ms. Les mesures edge mentionnent un état de 3.4K tokens et 64 états packés. Sur GPU, le modèle répond à une question en moins de 10 ms et traite une image de 384px en moins de 18 ms, avec les mêmes paramètres d’état signalés.
Disponibilité, mise en route et usages visés
Liquid AI publie d1-3B et d1-omni-600M en poids ouverts. L’éditeur recommande ces modèles pour obtenir des décisions rapides et structurées, y compris avec des entrées multimodales, en présentant d1-3B comme la meilleure qualité à sa taille et d1-omni-600M comme adapté lorsque l’empreinte compte. L’installation requiert transformers en version 5.14 ou supérieure, et le chargement se fait avec trust_remote_code activé. Les deux modèles sont disponibles sur Hugging Face, avec des démos via System One Arcade. Une référence de citation du blog est fournie par Liquid AI avec l’année 2026.