Abacus.AI publie des résultats chiffrés pour trois modèles ouverts optimisés pour des agents. Les hausses de scores varient fortement selon la base et la tâche, avec un accent revendiqué sur la stabilité en exécution longue et la compatibilité d’inférence. Les benchmarks cités montrent des progressions marquées pour Smaug Flash et des avantages ciblés pour Smaug Mini, tandis que Smaug Agentic met en avant un comportement plus régulier plutôt que des deltas spectaculaires.
La stabilité en exécution longue est mise en avant pour Smaug Agentic
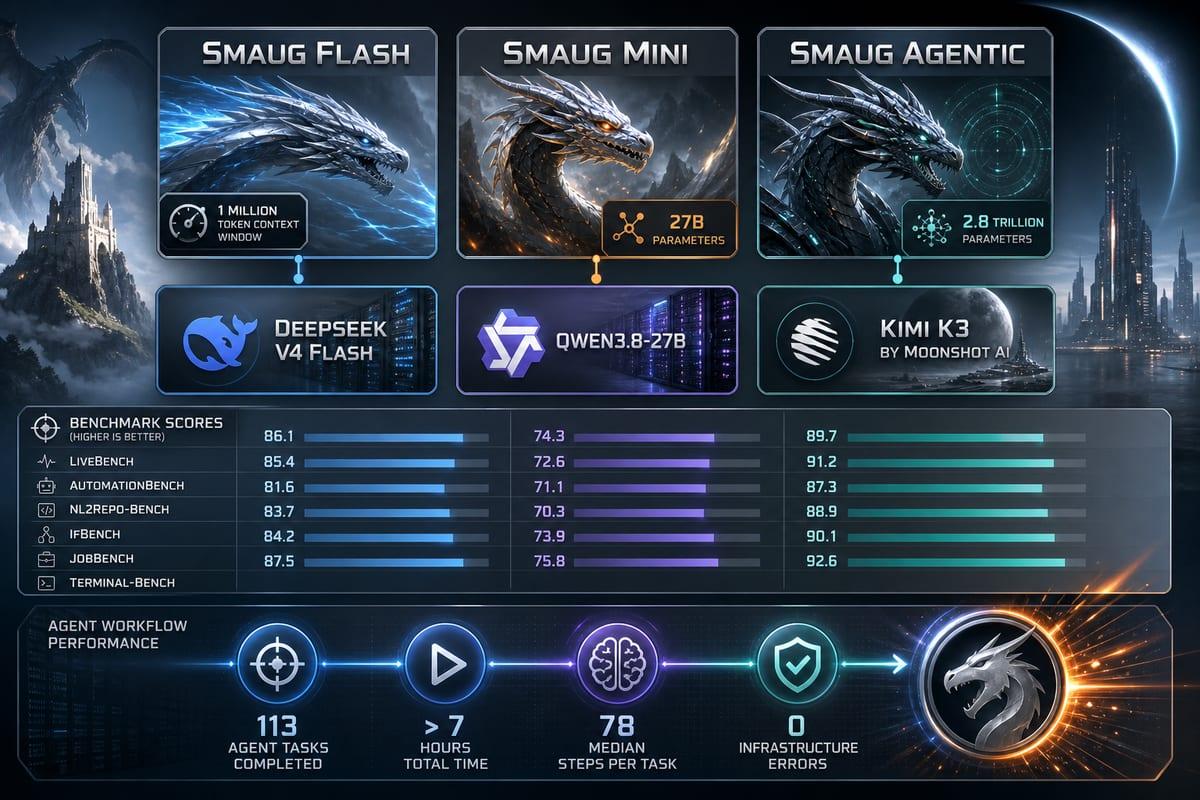
Smaug Agentic présente une variation totale de score de +0,3 par rapport à sa base, mais a exécuté 113 tâches de codage agentique sur plus de sept heures, avec une médiane de 78 étapes d’agent par tâche. Abacus.AI indique qu’aucune erreur d’infrastructure ni délai n’a été observé pendant ces séquences. L’accent est mis sur le changement comportemental, notamment la suppression du raisonnement erratique tout en préservant une délibération normale. La régularité lors de boucles longues est privilégiée par rapport à la seule hausse des scores.
Là où les bases restent devant : deux benchmarks où l’ajusté cède
Sur Terminal-Bench 2.1, la base de Smaug Agentic dépasse la version ajustée avec 88,3 contre 86,5. Sur MMMU-Pro, l’écart est léger mais toujours en faveur de la base avec 81,6 contre 81,0. Ces cas sont explicitement mentionnés comme des situations où l’optimisation n’apporte pas de gain de score.
Smaug Flash comble des écarts sur les tâches visées
Smaug Flash est un ajustement de DeepSeek V4 Flash, décrit comme rapide et économique mais sujet à des confusions lors d’un usage prolongé des outils. Le réglage fin a ciblé ce mode de défaillance. Les résultats rapportés indiquent un gain de 14,3 points en codage agentique sur LiveBench, avec un passage de 46,8 à 61,1. Sur AutomationBench, la progression annoncée est de 13,7 points, de 25,1 à 38,83. Sur NL2Repo-Bench, l’augmentation atteint 19 points, de 54,2 à 73,3. Ces gains sont présentés comme des corrections sur les flux de travail précisément visés.
Smaug Mini se démarque sur IFBench, JobBench et NL2Repo-Bench
Smaug Mini, itération avancée de Qwen3.8-27B dotée de 27 milliards de paramètres, est destiné notamment aux tâches multimodales et à l’usage d’outils. Abacus.AI indique qu’il a dépassé plusieurs modèles fermés sur certains benchmarks, et qu’il se classe devant Claude Sonnet 5, Claude Opus 4.6 et GPT-5.6 Luna sur IFBench, AutomationBench et JobBench. Les chiffres fournis incluent un gain de 13,5 points sur NL2Repo-Bench par rapport à la base, de 42,3 à 55,8, et un gain de 17,1 points sur JobBench, de 33,4 à 50,5. Les plus fortes hausses se situent en Mathématiques (+3,5) et en Raisonnement (+2,8). En parallèle, le score de codage agentique baisse légèrement face à la base (-0,6), ce qui illustre des compromis selon les catégories évaluées.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Pourquoi Abacus.AI a créé Smaug : limites d’agents et choix d’approche
Le développement d’agents confronte des difficultés pratiques : un agent peut produire une sortie sans accomplir la tâche et doit enchaîner compréhension, choix d’outil, analyse de la sortie et actions ultérieures. Sur des cycles répétés, il peut dériver de l’objectif, avec des coûts et risques supplémentaires. Abacus.AI rapporte des tâches durant plusieurs heures, mobilisant un contexte volumineux et des appels d’outils vers documents, API et bases de données, avec des risques d’essoufflement ou d’échec. L’entreprise affirme que transformer un modèle de pointe en bon agent relève de l’entraînement plutôt que du prompt, et que les LLM généraux ne sont pas toujours adaptés à l’usage prolongé, notamment avec un cache d’invite moins efficace et un contexte qui enfle. Plutôt que des ajustements d’invite ou des corrections locales, le choix a été d’améliorer les modèles eux-mêmes, conduisant à la famille Smaug. Les gains apparaissent là où les bases avaient le plus de marge, et la performance dépend fortement du modèle et du type de tâche.
Recette commune et variantes de réglage fin, avec compatibilité préservée
Trois modèles à poids ouverts composent la gamme Smaug, chacun reposant sur une architecture différente et tous accessibles publiquement sur Hugging Face. Une approche partagée combine des séquences humaines provenant de véritables tâches agentiques avec des données synthétiques axées sur des situations complexes, puis applique un filtrage pour exclure les cas qui maximisent la note sans réellement accomplir la tâche. Le but affiché consiste à privilégier la résolution de problèmes plutôt que le respect du format. Pour Smaug Flash, seules les matrices de facteur d’attention sont modifiées via trois adaptateurs LoRA, deux entraînés en supervisé et un par préférence, le reste demeurant identique à DeepSeek V4 Flash, ce qui maintient la compatibilité d’inférence et une fenêtre de contexte de 1 million de tokens. Pour Smaug Agentic, l’entraînement supervisé masque les tokens de raisonnement dans la perte afin de préserver le processus de pensée natif tout en améliorant l’usage des outils, sans modifier les paramètres architecturaux, pour un remplacement direct de Kimi K3. Smaug Mini applique la même logique à une base dense de 27B, avec des gains là où il existe de la marge et des compromis ailleurs. Abacus.AI affirme que nombre de réglages fins sacrifieraient le raisonnement au profit du format, et revendique consacrer le budget d’entraînement à des données qui améliorent effectivement le modèle plutôt qu’à exploiter des benchmarks.