Google propose un modèle spécialisé qui évalue jusqu’à 1 000 questions en une requête, avec des réponses probabilisées et une latence annoncée de l’ordre de la centaine de millisecondes. L’outil vise les décisions répétitives, mais Google insiste sur le périmètre: pas d’actions séquentielles, un besoin d’orchestration côté logiciel et des contrôles humains quand l’enjeu l’exige.
Des garde-fous exigés et des performances non garanties à l’extrême
Une estimation de probabilité ne suffit pas à trancher un cas ambigu : une IA rapide peut aussi se tromper rapidement. Les développeurs doivent surveiller les erreurs et définir des seuils de confiance adaptés, avec une validation humaine dès que les décisions peuvent avoir des conséquences importantes. La stabilité du temps de traitement n’est pas garantie lorsque mille questions s’accompagnent de fichiers très volumineux.
Déploiements internes : routage dans Notebook et contrôle de sécurité
Google a déjà recours à Gemini Decision 1 pour répartir les requêtes entre plusieurs modèles au sein de Gemini Notebook, ce qui permet, pour les demandes les plus fréquentes, de diminuer la latence jusqu’à 40 %. Ce modèle est également utilisé dans le cadre du prototypage rapide de Google Stitch ainsi que pour certains contrôles de sécurité associés aux outils MCP de Google Search.
Ce que fait le modèle : choisir parmi des options, avec un score de 0 à 1
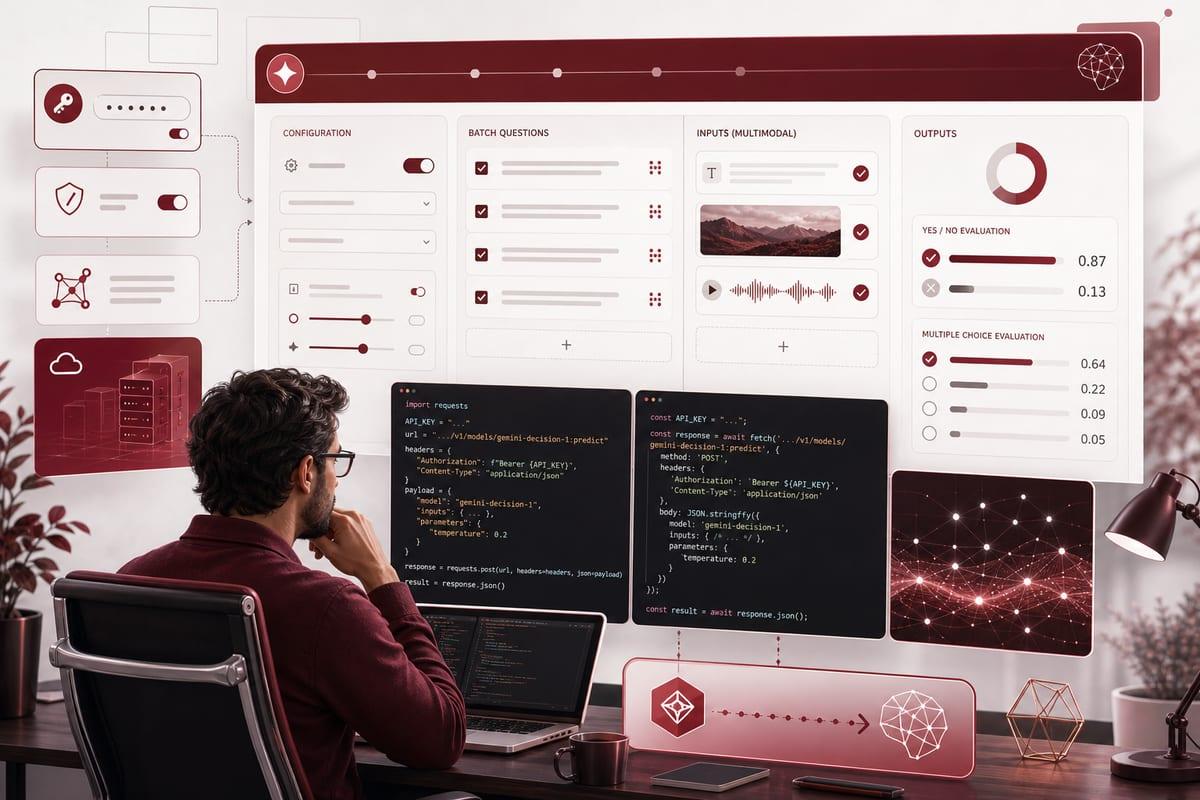
Le modèle délivre des probabilités sur des réponses prédéfinies plutôt que des textes développés. Trois formats sont prévus : oui/non, choix multiple de 2 à 255 possibilités, et notation selon une grille, chaque sortie étant assortie d’un score de confiance entre 0 et 1 afin de diriger les cas incertains vers un humain. Il peut aider des agents IA multi-outils, mais se limite à choisir parmi les options fournies et ne remplace pas, à lui seul, un processus métier.
Vous suivez la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Entrées multimodales et évaluation en masse jusqu’à 1 000 questions
Gemini Decision 1 prend en charge le texte, les images, l’audio, la vidéo et les fichiers PDF, avec une capacité de contexte d’environ 256 000 tokens. Il est capable d’analyser jusqu’à 1 000 questions distinctes lors d’un même passage, sans pour autant effectuer mille opérations consécutives : lorsque des décisions sont conditionnées par des étapes précédentes, c’est au logiciel de gérer ces relations de dépendance. Parmi les cas d’usage mentionnés figure celui d’un service client chargé de contrôler des pièces, d’évaluer des dommages ou d’orienter un dossier.
Accès développeur, latence annoncée et tarification à 0,10 $/M tokens
Le modèle s’adresse d’abord aux développeurs via Gemini Decisions API dans Google AI Studio, avec une intégration possible en Python, JavaScript ou via REST. Google annonce une latence totale de 150 à 250 ms, dont 50 à 100 ms pour le calcul du modèle sur des entrées jusqu’à 16 000 tokens, avec un temps quasi stable entre une et cent questions. Le tarif est affiché à 0,10 dollar par million de tokens en entrée, sans facturation de sortie ; les données partagées sont comptées une fois par requête et les instructions de chaque question s’ajoutent au total. Les tests publiés par Google avancent un coût presque cinq fois inférieur à Gemini 3.5 Flash-Lite sur leur jeu d’évaluations, une comparaison qui reste à confirmer en conditions réelles. Présenté le 11 novembre 2026, l’outil met l’accent sur la décision rapide via une API pour des tâches répétitives.