llama.cpp et sa brique ggml atteignent la version 1.0.0 avec des règles de version sémantique et une promesse de visibilité des ruptures. Le projet affiche une large prise en charge matérielle et de modèles, tout en musclant son infrastructure CI grâce à des outils Hugging Face et au soutien de grands fournisseurs de matériel.
CI renforcée et soutiens industriels annoncés
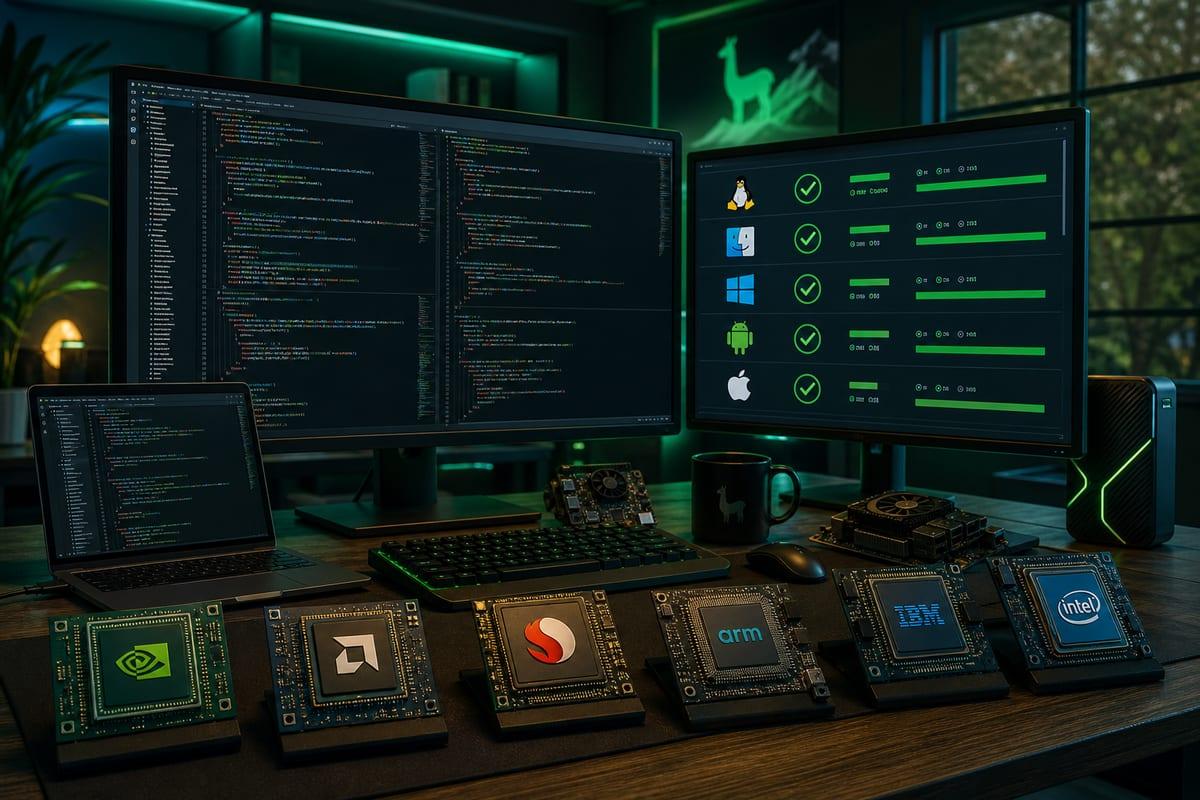
L'équipe indique investir davantage de ressources dans l'amélioration de son infrastructure d'intégration continue. Elle affirme s'appuyer sur HF Buckets et HF Jobs pour augmenter la capacité nécessaire à vérifier chaque changement sur les branches principales. Avec le soutien matériel de NVIDIA, AMD, Qualcomm, Arm, IBM et Intel, elle dit intégrer plus de runners auto-hébergés sur les principales plateformes matérielles. Parallèlement, les LLM sont intégrés au cycle de développement. Le projet décrit aussi une communauté open source composée de contributeurs expérimentés. L'équipe basée chez Hugging Face remercie ces contributeurs et présente la v1.0.0 comme une étape significative rendue possible par des efforts conjoints.
Couverture technique : backends dynamiques et 150 variantes prises en charge
Le moteur ggml est conçu pour fonctionner sur pratiquement tout type de matériel via des backends dédiés. Chaque backend peut être compilé en bibliothèque dynamique et chargé à l'exécution, et une liste des implémentations disponibles est fournie. Côté modèles, llama.cpp prend actuellement en charge plus de 150 variantes d'architecture et toutes les méthodes de décodage spéculatif grand public, avec un engagement affiché de support continu pour toutes les architectures de modèles. Le projet met aussi en avant l'exécution de LLM multimodaux sur un large éventail de machines, en s'appuyant sur la quantification, des backends optimisés et une base C/C++ portable.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Passage en 1.0.0 et garanties de stabilité d’API
Les bibliothèques passent en v1.0.0 : llama.cpp pour l'inférence en C/C++ et ggml comme bibliothèque de tenseurs pour l'apprentissage automatique. Les projets ggml-org suivent des règles de version sémantique : un changement incompatible dans l'API C publique située dans ./include entraîne une montée de version majeure ; une fonctionnalité rétrocompatible, une mise à jour de backend, un support de modèle ou un ajout d'API relèvent d'une version mineure ; une correction sans changement d'API d'une révision de correctif. L'équipe prévoit d'indiquer explicitement toute incompatibilité d'API ou d'ABI via un changement de version majeure et d'en renforcer la visibilité pour les consommateurs en aval. Des artéfacts de pré-version sont proposés pour Linux, macOS, Windows, Android et iOS, ainsi que pour Windows, macOS et Linux. Le projet revendique 3,5 années d'existence et de nombreuses dépendances en aval. Il anticipe une poursuite de l'adoption, souligne que chaque intégration accroît la dépendance aux interfaces et affirme que la stabilité d'API est prioritaire, au même titre que la qualité de code et la maîtrise de l'architecture.