Deux modèles Granite 4.1 en avant-première s’ouvrent au balisage LLMON, un format pensé pour expliciter instructions, données et exigences dans le contexte des LLM. Les promoteurs annoncent des gains nets contre les injections de prompt indirectes sur plusieurs benchmarks, tout en conservant des performances comparables aux modèles instruct. Des outils de conversion sans perte depuis et vers JSON accompagnent le lancement.
Des gains mesurés contre les injections, avec un périmètre défini
Les concepteurs indiquent que les modèles LLMON évitent 47 % d’attaques de plus que le meilleur modèle de pointe testé sur OPI et 95 % de plus que le meilleur modèle open-source. Ils rapportent des tendances similaires sur les benchmarks ASB et StruQ. L’évaluation a été menée sur OPI, avec plusieurs stratégies d’attaque, et une définition de la robustesse comme 1 moins le taux de succès des attaques, c’est-à-dire la part des attaques où le modèle ne réalise pas l’instruction injectée. Les jeux cités examinent des injections indirectes statiques. L’équipe précise travailler à renforcer la défense face à des attaques adaptatives multi-tours. Selon les promoteurs, les modèles non LLMON exécutent les instructions injectées avec une forte probabilité, alors que pour certains benchmarks les taux de succès chutent à presque zéro avec LLMON.
Mise en œuvre immédiate dans un flux de chat existant
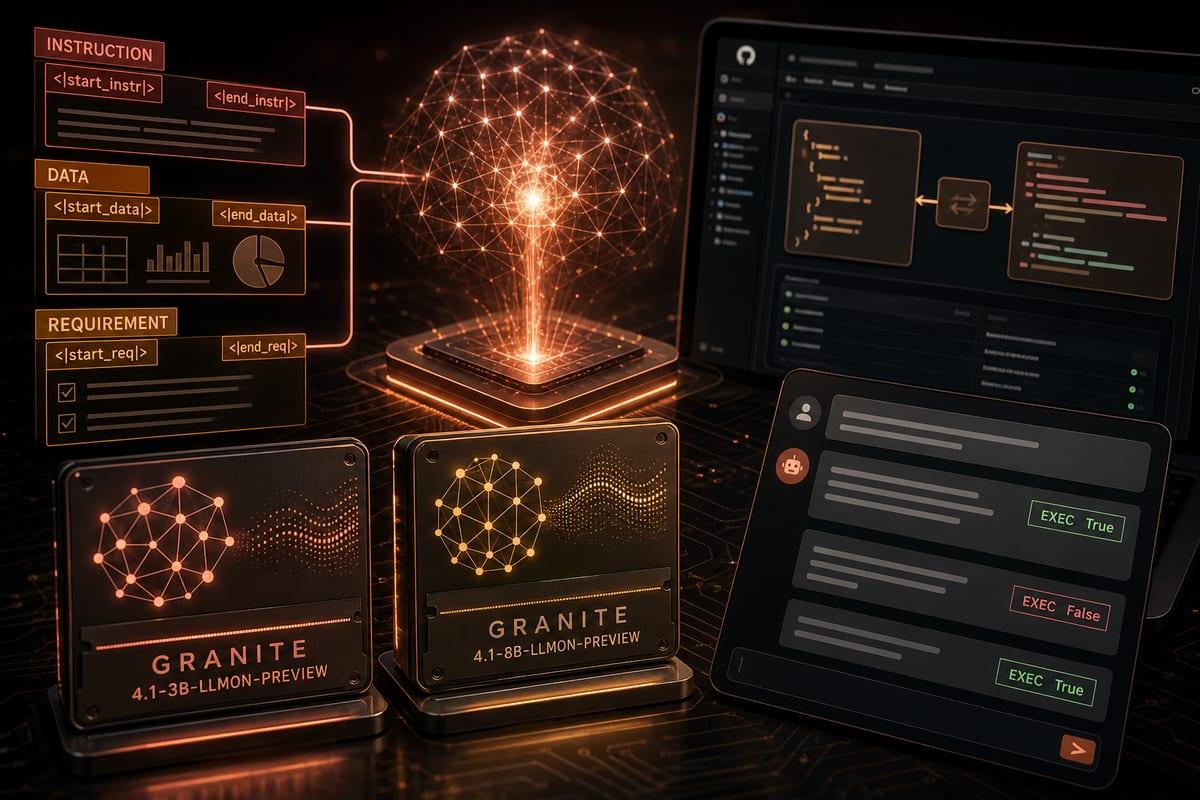
Les avant-premières LLMON sont livrées avec un modèle de chat permettant d’utiliser une liste de messages et apply_chat_template comme d’habitude. Il suffit de nommer les parties de l’échange, telles que instruction, données et exigences ; le modèle de chat rend ces éléments en blocs LLMON. Aucun pipeline de conversion n’est requis pour ce mode. Un support natif est déjà présent dans Mellea, qui LLMONise automatiquement ses appels. Des convertisseurs et notebooks assurent des traductions sans perte entre JSON et LLMON, et la bibliothèque préserve les structures internes comme un document JSON en blocs adressables individuellement.
Ce que change le balisage LLMON dans le contexte
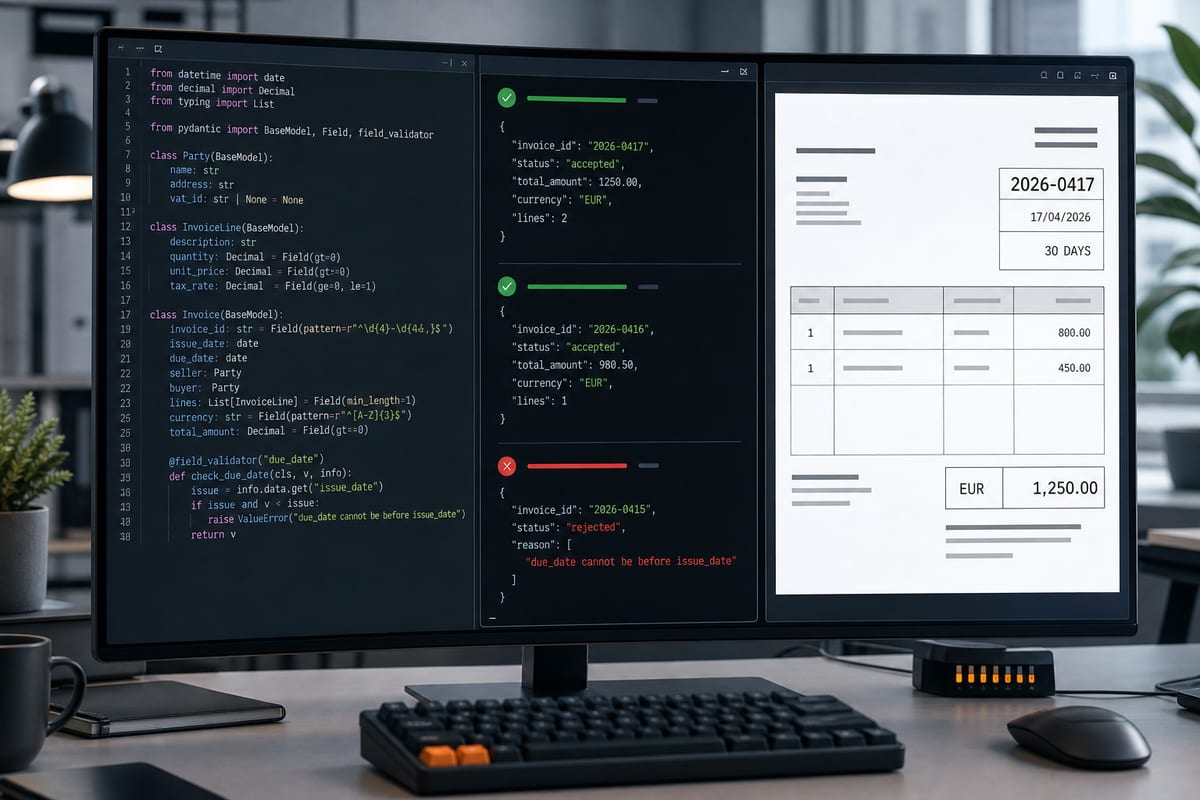
LLMON formalise un langage de balisage pour exposer explicitement structure et sémantique au modèle. Des balises significatives, entourées de délimiteurs réservés, décrivent des schémas sans ambiguïté et l’imbrication. Des identifiants uniques lient instructions et données ciblées. Les types d’éléments, comme instructions, données et exigences, sont marqués pour un usage par l’application et le modèle. Dans un échange, chaque partie peut être nommée et marquée exec True ou False ; un bloc d’exécution associe alors instruction et données, les autres éléments restant dans le contexte sans référence. Les concepteurs affirment que cette séparation réduit l’absorption de contenus hors sujet et limite l’impact d’instructions malveillantes cachées, et soutiennent qu’il n’est plus nécessaire de forcer des sorties JSON. Il est possible de définir des structures et balises propres et d’ajuster un LoRA pour les interpréter.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Pourquoi JSON résiste mal aux modèles de langue
JSON vise les parseurs plutôt que les modèles causaux : la grammaire n’est pas imposée par le tokenizer et la structure repose sur des caractères pouvant figurer dans du texte ordinaire. Pour un modèle, un guillemet vaut un guillemet, qu’il ferme un champ ou apparaisse dans un document, et les règles d’échappement restent des motifs statistiques. La profondeur d’imbrication, comptée par crochets, est présentée comme problématique pour des transformers sur de longues distances. LLMON adopte au contraire un balisage de type XML avec délimiteurs réservés, des balises déclarées au début des intervalles et des limites explicites, et des imbrications localisées pour éviter le suivi lointain. Des outils assurent les conversions sans perte entre JSON et LLMON.
Deux modèles en avant-première et une boîte à outils
Deux variantes dérivées de Granite 4.1 sont proposées en avant-première : granite-4.1-3b-LLMON-preview et granite-4.1-8b-LLMON-preview. Elles arrivent avec un dépôt GitHub contenant outils et exemples. Les promoteurs affirment que ces modèles offrent des performances générales comparables aux Granite 4.1 Instruct, et qu’un remplacement des 3B ou 8B actuels par les avant-premières LLMON doit conserver ce niveau tout en augmentant la résistance aux injections.
Choix d’entraînement et signaux d’apprentissage utilisés
Les modèles partent des checkpoints de base Granite 4.1, avec l’apprentissage du comportement LLMON en post-entraînement plutôt qu’un format de chat surimposé. Six délimiteurs dédiés, ajoutés au tokenizer en tokens réservés, bornent les balises et autorisent l’imbrication et l’ancrage. Le corpus d’ajustement d’instructions a été re-sérialisé en blocs adressables avec, pour chaque échange, un bloc d’exécution nommant l’instruction, ses entrées et la destination de la sortie. Le mélange de tâches reproduit celui d’un instruct classique (chat, multi-tour, RAG, appel d’outil), ce qui, selon l’équipe, maintient des performances proches des approches conventionnelles. Des leurres, présents mais non liés, forcent le modèle à suivre le bloc d’exécution et à ignorer le reste.
Le problème ciblé : un contexte riche mais exploitable
Le contexte d’un modèle de langue agrège prompts système, historiques de dialogue, instructions appliquées à des documents récupérés, réponses d’outils, données utilisateur, contraintes de sortie et chaînes de raisonnement. Cette richesse, souvent implicite ou encodée en formats peu adaptés aux LLM, est présentée par ses concepteurs comme une source de fragilité et une surface d’attaque via des injections dissimulées dans les données. L’injection de prompt indirecte consiste précisément à enfouir une instruction malveillante dans ces charges. La séparation stricte entre instructions et données mise en avant par LLMON vise directement ce vecteur.