Terminal X dit avoir rapproché ses agents IA du jugement d’investisseurs seniors, avec 88,6 % d’accord mesuré sur 500 cas et des coûts par requête annoncés en baisse d’environ 30 % par rapport à un modèle concurrent. Le dispositif s’appuie sur des mémoires versionnées des méthodes de chaque client et un agent d’évaluation notant 54 critères, opérant dans des salles de données privées.
Des résultats chiffrés, des usages déclarés et une extension annoncée
Terminal X fait état de la création de 1 700 mémoires d’entreprise et de l’exécution de plus d’un million de flux de travail personnalisés. La société précise également que 81 % de ses utilisateurs actifs mensuels sont actifs chaque semaine. Sur 500 jugements notés, elle mesure 88,6 % d’accord entre son agent d’évaluation sur GPT‑6.1 Sol et un examinateur humain senior, contre 86,4 % pour le meilleur modèle suivant. Terminal X annonce par ailleurs un coût par requête environ 30 % inférieur avec GPT‑6.1 Sol, pour une vitesse similaire, et cite le cas d’un client de capital‑investissement évoquant 2,4 millions de dollars d’économies annualisées grâce à l’automatisation des diligences et des mémos. La société prévoit d’étendre les mémoires des bureaux aux individus. Son PDG, Hyun Hong, avance que les entreprises performantes « posséderont leur jugement en tant que données », et que le rôle de la plateforme est de rendre ce jugement mesurable, conservable, améliorable et réutilisable.
Un jugement rendu auditable par un agent vérificateur et 54 critères
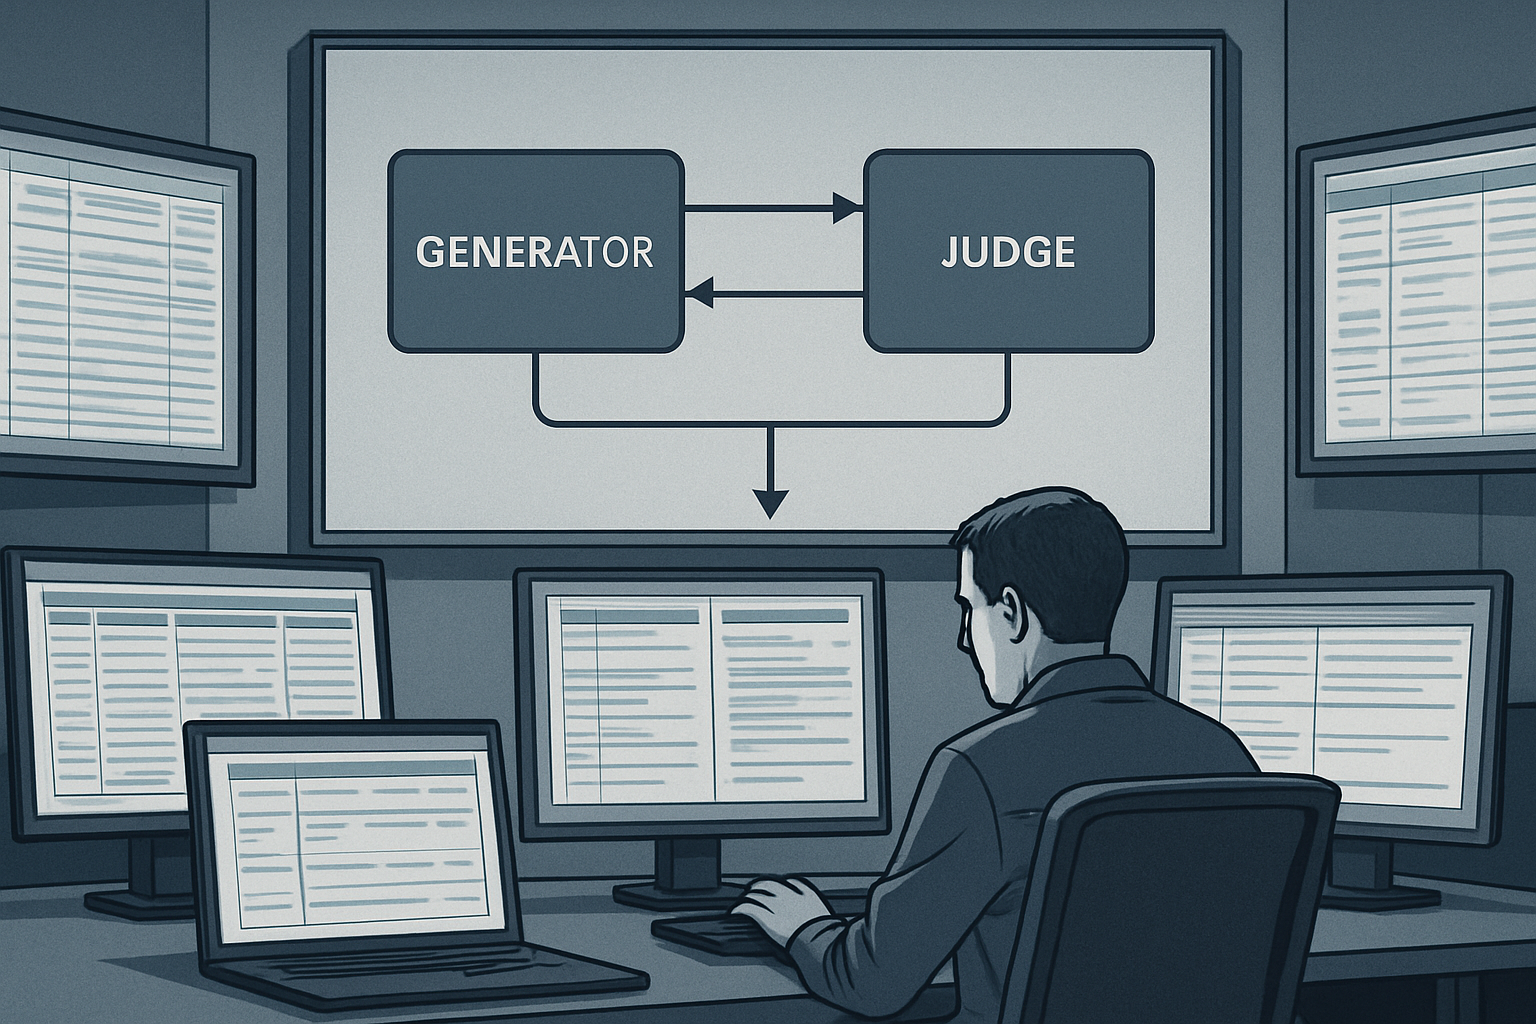
La vérification des réponses est assurée par un agent d’évaluation, orchestré sur GPT‑6.1 Sol et d’autres modèles d’OpenAI, qui relit chaque sortie comme le ferait un VP face au travail d’un analyste. Cet agent applique un cadre de 54 critères, examinant notamment la provenance des chiffres et citations, la cohérence du récit et l’alignement avec le point de vue interne. Chaque contrôle produit un résultat réussite ou échec ; en cas d’échec, une raison concise et une meilleure source ou un texte corrigé sont fournis et deviennent une nouvelle entrée de Mémoire. Des erreurs typiques incluent une source omise, une comparaison fautive ou une thèse s’écartant du point de vue interne. Les évaluations sont tracées, chaque requête de production étant auditable avec son historique des étapes, des sources, du modèle et du raisonnement.
Architecture: encoder les méthodes des équipes en agents spécialisés
Capital Memory vise à réduire la dette de mémoire en encapsulant les méthodes d’investissement dans des agents. Pour chaque client, des agents sont élaborés afin de reproduire les pratiques d’investissement des meilleurs professionnels de l’entreprise. Les équipes de Terminal X restent plusieurs semaines sur place pour rétroconcevoir les mémos et saisir les processus informels, avant de transposer ces méthodes dans plusieurs centaines d’agents adaptés à chaque classe d’actifs et à chaque stratégie, avec des sous-agents pour chaque étape. GPT‑6.1 Sol prend en charge les étapes de jugement et à large contexte, tandis que GPT‑6 Luna assure les étapes à fort volume. Les apprentissages sont stockés sous forme de Mémoire versionnée, qui compile analyses passées, décisions de comité, instructions de flux et points de vue internes, puis se transforme en flux de travail répétables.
Vous suivez la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Déploiement et données: salle privée, multilingue, sur site ou cloud
Les agents peuvent être déployés sur site chez le client ou dans le cloud de Terminal X. Ils opèrent au sein d’une salle de données privée dédiée au partage et à la gestion de données d’investissement sensibles. Les traitements couvrent des documents en anglais, coréen, japonais et chinois. Les modèles d’OpenAI, dont GPT‑6.1 Sol et GPT‑6 Luna, assurent le raisonnement à l’intérieur de ces agents.
Sélection des modèles et détection des dérives de style d’investissement
Terminal X choisit ses modèles sur la base de ses propres évaluations. Sur 500 jugements notés, l’agent d’évaluation armé de GPT‑6.1 Sol a affiché 88,6 % d’accord avec un examinateur senior, contre 86,4 % pour le meilleur suivant, soit 220 points de base d’écart. L’entreprise indique que GPT‑6.1 Sol surperforme notamment sur les dérives de style d’investissement, par exemple lorsque des scénarios de retournement conduisent à recommander du crédit en difficulté ou du financement de sauvetage plutôt qu’une opération conforme au mandat de rachat. L’agent sur GPT‑6.1 Sol a détecté environ 25 % d’écarts supplémentaires de ce type. L’efficacité des tokens permet un processus de révision plus profond à budget constant : tester la thèse face au mandat, puis face aux transactions récentes, relancer les verdicts incertains et réconcilier les résultats. Ce niveau de révision a signalé des transactions que des passages uniques sur un modèle comparable validaient.
Du capital humain à la dette de mémoire: formaliser le raisonnement
Terminal X décrit un avantage concurrentiel bâti opération par opération mais dépendant du jugement de quelques seniors, d’où un risque de dette de mémoire lors de leur départ. Pour y répondre, ses ingénieurs, issus notamment de JPMorgan et Blackstone, travaillent avec les équipes d’investissement pour encoder méthodes et critères au sein d’agents. Selon la société, GPT‑6.1 Sol aide l’agent d’évaluation à détecter environ 25 % de recommandations en plus qui s’écartent d’un mandat, pour un coût par requête environ 30 % inférieur au meilleur modèle alternatif. Hyun Hong met en avant la capacité de raisonnement long terme et l’efficacité des tokens pour rendre l’évaluation plus profonde et auditable. Ken Lee souligne que chaque correction apportée par un analyste apprend au système comment fonctionne la maison, et que l’usage prolongé le rapproche de la pensée de l’équipe.