Tu veux les meilleurs outils IA avant les autres ?
On teste et on décrypte les nouveaux outils IA chaque soir, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Cloudflare active un contrôle fin pour refuser l’entraînement des modèles sans couper l’indexation des moteurs qui respectent des critères « Accountable ». Les options s’appliquent au niveau du domaine, migrent automatiquement pour les sites existants et s’inscrivent dans une trajectoire incluant un réglage des résumés IA prévu début 2027.
Un contrôle pensé pour durer, avec un cap fixé à début 2027
Cloudflare prévoit pour début 2027 un réglage unique côté plateforme afin de contrôler la part de contenu reprise dans les résumés générés par IA, ce qui évitera d’avoir à négocier séparément avec chaque opérateur. Dès à présent, le réglage Block s’étend aux crawlers mixtes et bloque aussi l’accès d’Applebot, de Bingbot et de Googlebot, y compris pour la recherche. Par ailleurs, la possibilité de refuser les résumés IA via Cloudflare est annoncée pour 2027.
Paramétrage au niveau du domaine et migration sans action
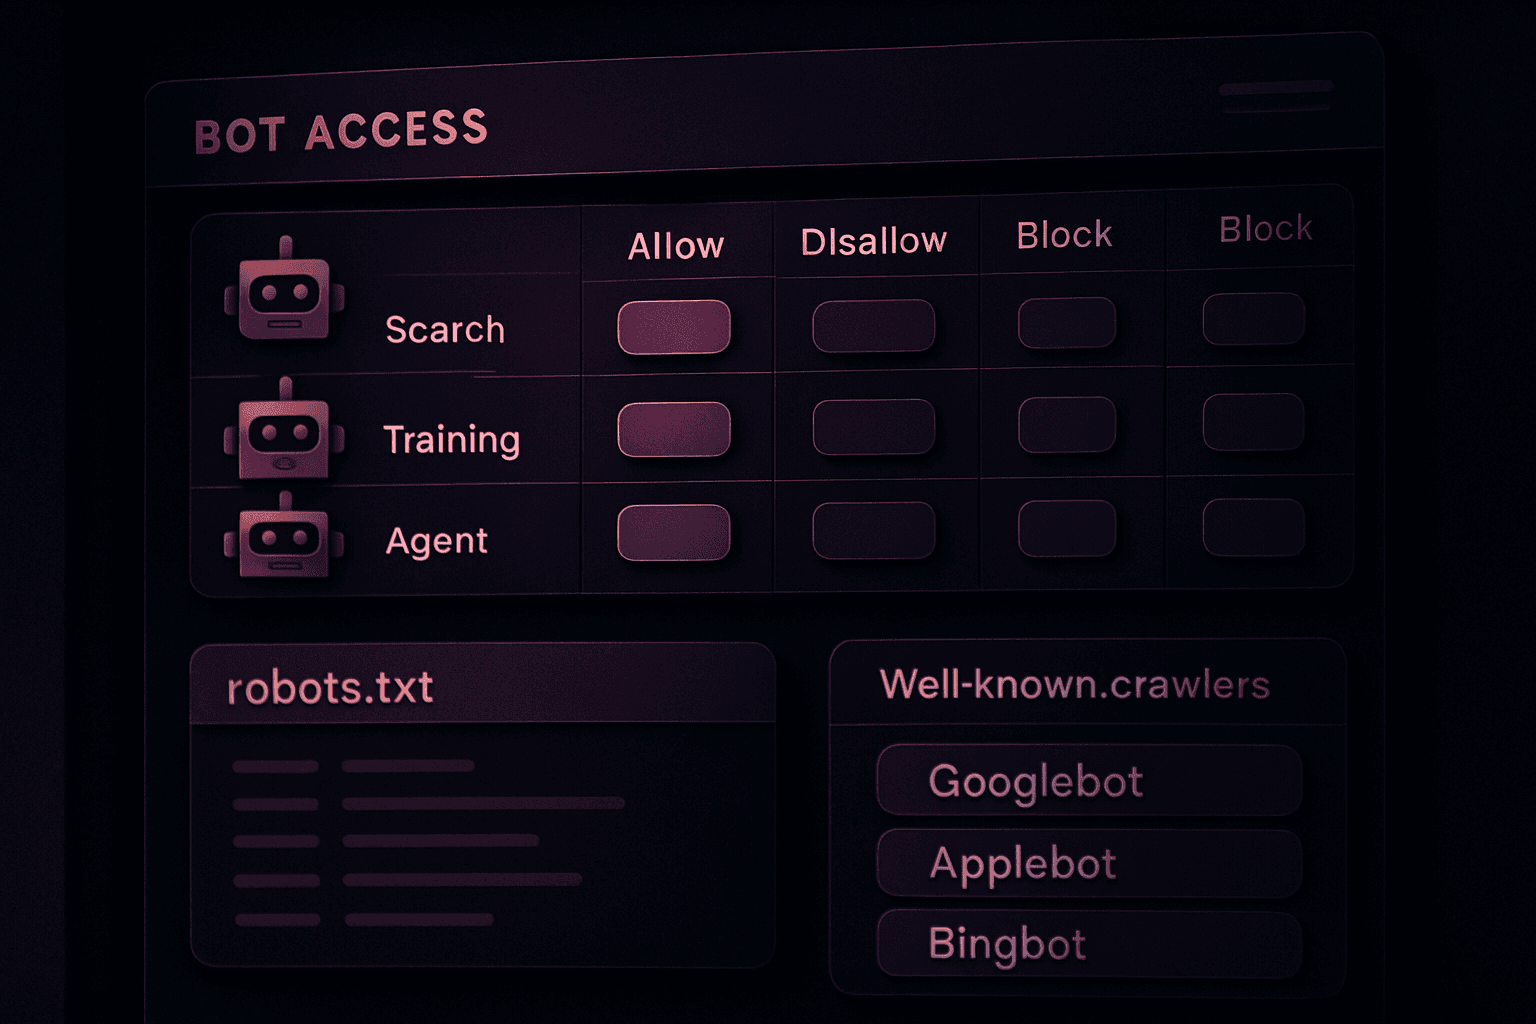
Les modifications portent sur Bot Management ainsi que sur AI Crawl Control. Les options de contrôle, accessibles pour toutes les formules, s’appliquent au niveau du domaine via les paramètres de sécurité du tableau de bord. Cloudflare identifie trois types de comportements des robots : Search pour l’indexation, Training pour l’entraînement des modèles et Agent pour les agents sollicités par un utilisateur. Quatre options de configuration sont disponibles : Allow, Disallow AI Training qui s’applique uniquement au comportement Training, Block on pages with ads qui cible uniquement les pages comportant des publicités détectées, et Block qui empêche l’accès de tous les robots concernés. Les sites déjà paramétrés n’ont aucune démarche à effectuer : leurs réglages actuels sont automatiquement conservés. Lorsqu’un domaine est configuré sur Block ou Block on pages with ads pour l’entraînement, il est automatiquement transféré vers Disallow AI Training. Si l’option Block AI Bots était utilisée précédemment sur un domaine, celui-ci passe à Allow pour Search, Disallow AI Training pour Training et Block on pages with ads pour Agent. Pour les nouveaux domaines, deux options de configuration prédéfinies sont disponibles : les sites dont le financement repose sur la publicité se voient attribuer Disallow AI Training pour Training et Block on pages with ads pour Agent, tandis que les autres conservent Allow sur les trois paramètres.
Qui reste indexé et à quelles conditions « Accountable »
Le statut « Accountable » est attribué aux opérateurs qui remplissent ou s’engagent à remplir quatre conditions : fournir une possibilité de refuser l’entraînement via robots.txt ou une solution équivalente ; offrir la possibilité de refuser l’utilisation des résumés IA auprès de l’opérateur ; permettre une visibilité au niveau de chaque URL concernant les pages accessibles à l’entraînement, accompagnée de statistiques sur la façon dont le contenu apparaît dans les résultats de recherche ; et assurer que le refus de l’entraînement n’a pas d’impact sur le référencement traditionnel. Apple, Google et Microsoft répondent à ces exigences grâce à des fonctionnalités déjà déployées et à des engagements datés pour les aspects restants. Pour ces sociétés qualifiées d’« Accountable », l’indexation demeure autorisée même en cas de refus de l’entraînement. Le paramètre Disallow AI Training ajoute une instruction de refus spécifique à chaque opérateur dans le fichier robots.txt du site.
Mécanismes par moteur : Google-Extended, Applebot-Extended et la trajectoire de Bing
Chez Google, la directive de refus d’entraînement est appliquée à l’aide d’une règle Disallow sur Google-Extended ; chez Apple, la même consigne s’effectue via Applebot-Extended. Microsoft doit encore intégrer la gestion d’une préférence de non-entraînement dans le fichier robots.txt, une évolution prévue pour le début de l’année 2027 ; jusque-là, activer Disallow AI Training ne transmet aucune information à Bing, dont la désactivation de l’entraînement repose sur la balise NOARCHIVE. Les robots utilisés pour l’entraînement par Amazon, Anthropic, Meta et OpenAI, qui sont séparés de leurs robots de recherche, continuent d’être bloqués. Selon Cloudflare, moins de 1 % des sites qu’il protège choisissent de bloquer les robots de recherche, tandis que 17 % activent un mécanisme de blocage de l’entraînement.
Un jalon de plus dans la gestion du crawl et des agents
Cette annonce s’inscrit dans une série d’initiatives de Cloudflare autour du crawl et de l’IA. L’entreprise a notamment piégé des robots d’entraînement dans des pages générées avec AI Labyrinth, lancé le modèle de paiement au crawl « Pay per Crawl », proposé de servir automatiquement une version Markdown des pages aux agents, et ouvert un endpoint permettant d’explorer un site entier en une seule requête API.