Google propose une API de décisions qui renvoie directement des probabilités calibrées au lieu de texte. Annoncée à 0,10 $ par million de tokens d’entrée et donnée pour 150 à 250 ms de latence de bout en bout, elle arrive sans mise en cache ni batching et reste plus chère par token que Jev.
Pas de cache ni de lot, et un coût d’entrée supérieur à Jev
L’API ne propose pas encore de mise en cache des invites ni d’API par lot, ce qui signifie que tout contexte répété est refacturé dans son intégralité. À 0,10 $ par million de tokens d’entrée, Gemini Decision 1 reste plus cher que Jev 1.14 affiché à 0,042 $ par million. Dans le tableau comparatif, la mise en cache est indiquée comme non prise en charge côté Google, prise en charge chez OpenAI Decisions, et non divulguée chez Jev. Côté latence, Google annonce 150 à 250 ms de bout en bout, tandis qu’OpenAI Decisions est décrit comme environ dix fois plus rapide que son API Responses, sans chiffre équivalent publié pour Jev.
Usages internes et écosystème en déploiement
Google rapporte un usage interne dans Gemini Notebook pour router vers différents niveaux de modèle, avec jusqu’à 40 % de latence en moins sur des requêtes quotidiennes. Google Labs utilise les Creative Chips pour sélectionner des réactions emoji parmi plus de 200 possibilités. L’API est utilisée par le canevas rapide de Stitch afin de générer des maquettes jouables en quelques secondes. Le support dans l’écosystème est actuellement en cours d’intégration sur OpenRouter, LangChain, Vercel AI SDK, LiteLLM, Pydantic AI, Pipecat, LiveKit et OpenCode, et une prise en charge dans Gemini sur Google Cloud est annoncée comme à venir.
Une API de décision multimodale qui renvoie des scores calibrés
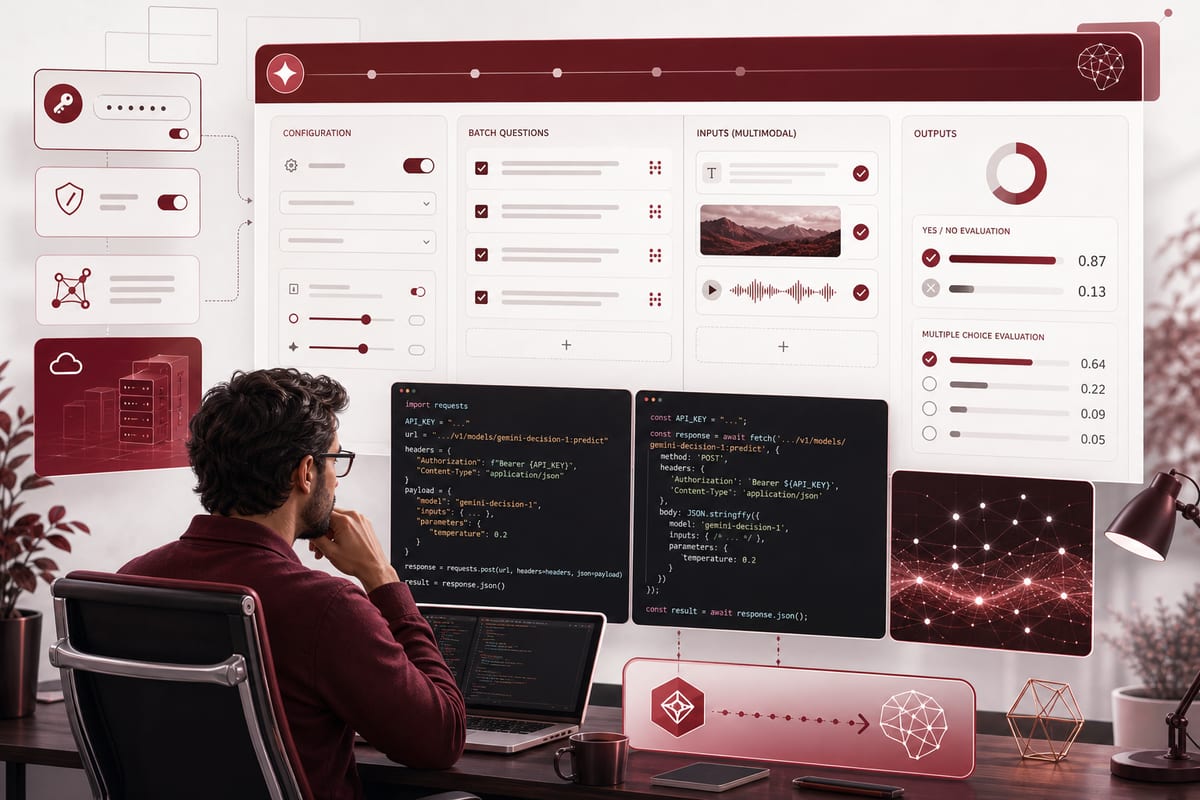
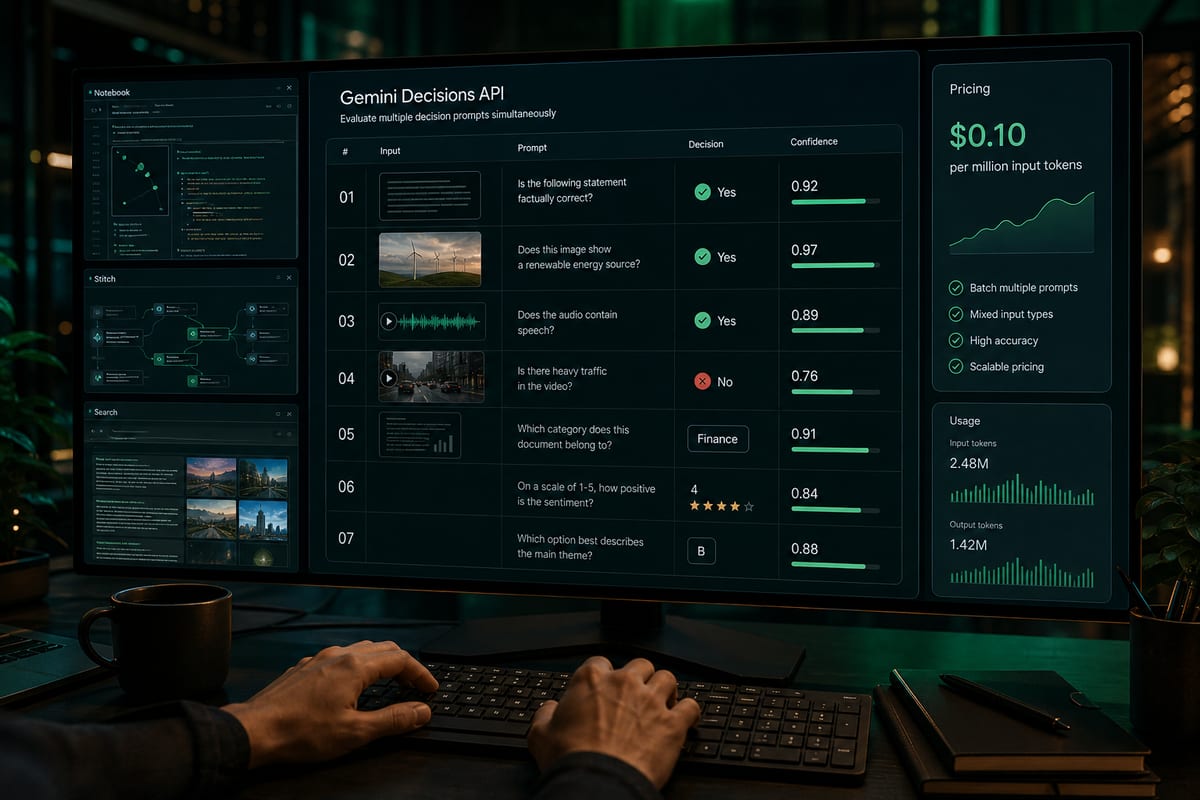
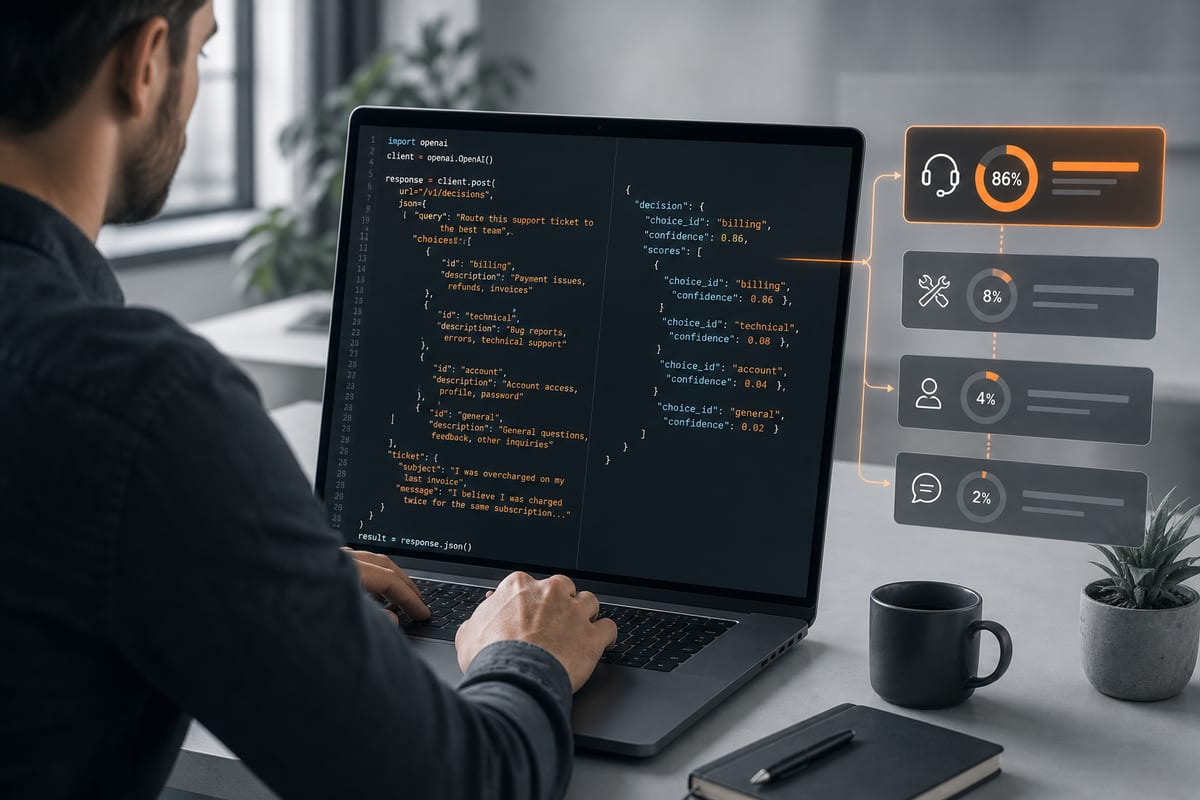
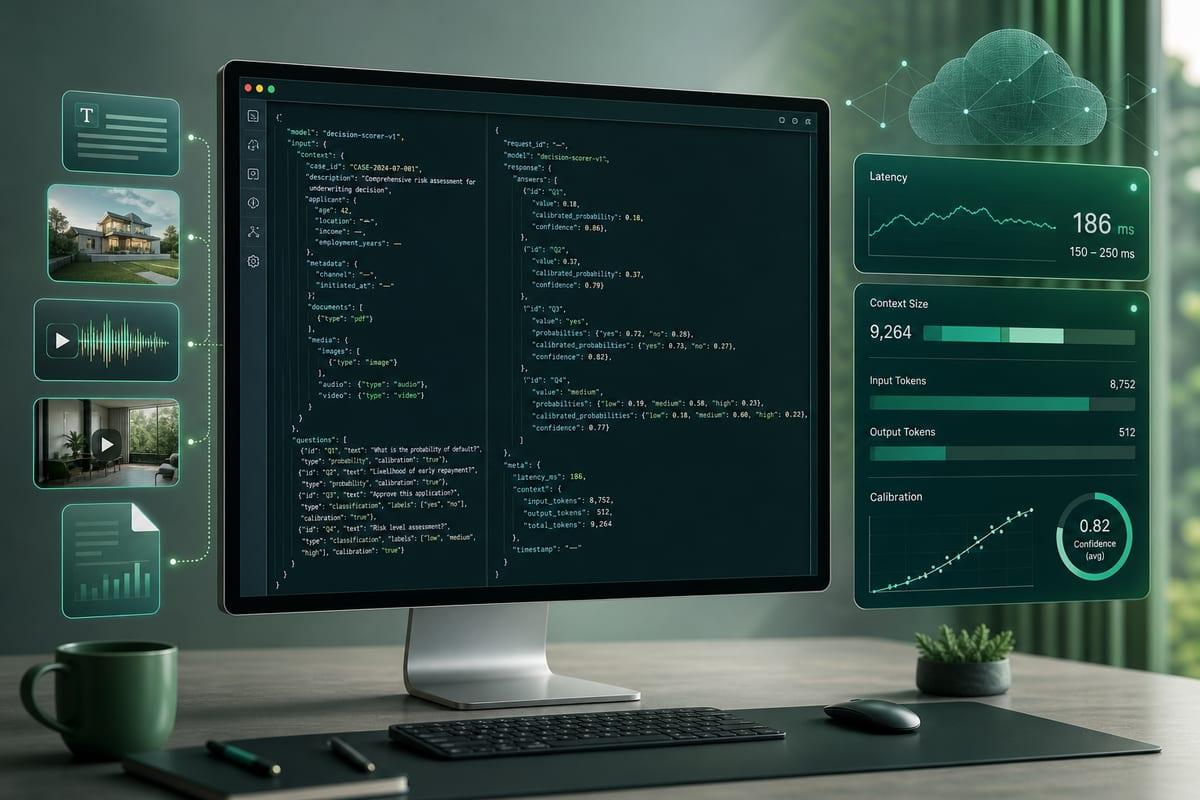
Google lance Gemini Decisions, basée sur le modèle spécialisé Gemini Decision 1, qui ne génère pas de texte et renvoie directement des probabilités calibrées. Le modèle est multimodal et traite texte, image, audio, vidéo et PDF en un seul passage, avec des réponses accompagnées d’une confiance entre 0 et 1. Chaque requête regroupe un ID de modèle, une entrée partagée et une carte de questions, celles‑ci étant évaluées en parallèle et sans interférences mutuelles. Trois formats de questions sont prévus : oui/non avec probabilité bornée entre 0,01 et 0,99, choix unique sur 2 à 255 options avec probabilités par option, et score sur 2 à 255 niveaux ordonnés. L’API traite jusqu’à 1 000 questions par appel avec 0 token de sortie. Google recommande de rediriger les cas de faible confiance vers un plan de secours ou une revue humaine.
Vous codez avec l’IA ?
Outils, agents et nouveautés dev IA décryptés, chaque soir en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Latence annoncée et facturation centrée sur l’entrée partagée
Google fait état d’un temps de calcul médian compris entre 50 et 100 ms et d’une latence de bout en bout allant de 150 à 250 ms, ces valeurs s’appliquant à des entrées jusqu’à 16K tokens et restant quasiment stables pour un nombre de questions allant de 1 à 100. L’entrée partagée n’est facturée qu’une unique fois par requête, chaque question ne générant des frais que pour ses propres tokens d’instruction et de critères, sans coût supplémentaire pour les tokens de réflexion, de transcription ou d’OCR. La capacité de contexte disponible s’élève à 262 144 tokens pour l’entrée partagée et pour les questions. Le service est accessible uniquement via l’API Gemini Developer en v1beta, facturé 0,10 $ par million de tokens d’entrée, et supporte jusqu’à 1 000 questions par requête.
Benchmarks auto-déclarés et calibration mesurée
Selon les chiffres fournis par Google, Gemini Decision 1 obtient la meilleure performance sur 7 des 9 benchmarks d’exactitude publiés, avec la plus faible erreur de calibration. Le modèle atteint 92,2 % sur JevBench et enregistre son plus bas Macro‑F1 à 58,7 % sur Amazon ESCI. Il est à 79,9 % sur When2Call contre 82,0 % pour Jev 1.14. D’autres scores rapportés incluent 79,7 % sur New Yorker Caption, 86,2 % sur Mind2Web Multimodal, 79,8 % sur PubMedQA, 86,0 % sur Global‑MMLU‑Lite, 71,8 % sur MMAU et 69,1 % sur Video‑MME sans sous‑titres. L’erreur Top‑1 ECE est donnée à 0,0250, soit environ la moitié de celle de Jev 1.14 à 0,0494. Pour sept évaluations partagées, le prix total cité est de 0,88 $ pour Gemini Decision 1 contre 0,68 $ pour Jev 1.14, 0,93 $ pour GPT‑6 Luna et 4,14 $ pour Gemini 3.5 Flash‑Lite. Google affirme par ailleurs que Gemini Decision 1 est presque cinq fois moins cher que Flash‑Lite sur cette suite.
Accès développeur et comparaisons d’envergure
L’endpoint est actif sur Gemini Developer API v1beta et nécessite le SDK google‑genai 3.2 ou supérieur, avec un niveau sans coût pour prototyper dans Google AI Studio et des guides pour Python, JavaScript et REST. Dans les comparaisons publiées, OpenAI Decisions affiche un contexte de 1 050 000 tokens sur sa page modèle, tandis que Jev 1.14 indique 64K par requête, extensibles à 262K avec en‑tête opt‑in. Gemini Decision 1 accepte de 1 à 1 000 questions par requête contre 1 à 400 pour OpenAI Decisions, et Jev est limité par le contexte sans plafond chiffré. Les modalités d’entrée listées vont jusqu’au PDF, à la vidéo et à l’audio pour Gemini Decision 1, là où OpenAI Decisions cite texte, image et JSON, et Jev le texte. Les prix d’entrée référencés sont 0,10 $ par million pour Google, 0,10 $ non mis en cache pour OpenAI et 0,042 $ pour Jev. L’API Google reste réservée à l’hébergement Google, sans auto‑hébergement.