Google met sur le marché Gemini Decisions, une API de décision alimentée par le modèle Gemini Decision 1. L’offre propose une évaluation multimodale en un seul passage, des scores de confiance pour chaque réponse et une tarification à 0,10 $ par million de tokens d’entrée, sans facturation de sortie. Selon l’entreprise, la latence médiane descend à 50–100 ms côté modèle et l’erreur de calibration est minimale sur ses benchmarks.
Tarifs simples et intégrations en déploiement
Gemini Decision 1 est tarifé à 0,10 $ pour 1 million de tokens d’entrée et 0 $ pour les tokens de sortie, avec un niveau sans coût pour prototyper dans Google AI Studio. L’entrée partagée n’est facturée qu’une fois par requête, quel que soit le nombre de questions posées. Des intégrations avec OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit et OpenCode sont en cours de déploiement, et un support pour Gemini dans Google Cloud est annoncé. Des démos publiques sont proposées, dont Doorstep Parcels, Speed Sketch et Find the Zoo Keeper. Il est possible de démarrer dès aujourd’hui via une clé API obtenue dans Google AI Studio, avec des guides disponibles pour Python, JavaScript et REST.
Évaluation en un passage sur texte, image, audio, vidéo et PDF
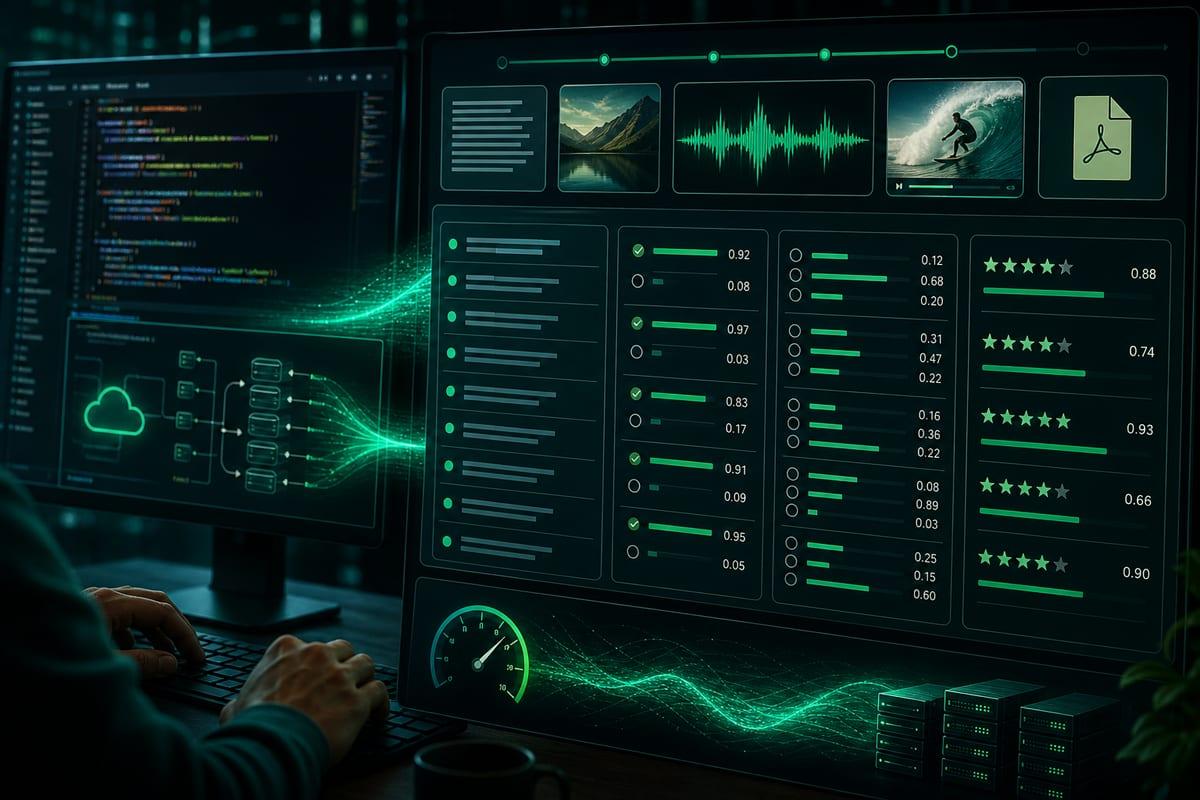
Reposant sur l’architecture multimodale propre à Gemini, l’API prend en charge en une seule opération le texte, les images, l’audio, la vidéo et les fichiers PDF. Il est possible d’associer plusieurs modalités dans une unique soumission, comme un fichier audio d’appel accompagné de métadonnées de compte, ou une réclamation scannée au format PDF avec des photographies de dommages, tout en ajustant la résolution afin de contrôler à la fois la précision visuelle et la consommation de tokens. Une requête unique autorise l’analyse de questions variées et attribue à chacune un indice de confiance situé entre 0 et 1, ce qui permet d’orienter les cas incertains. Trois types sont proposés : noul pour estimer une probabilité binaire avec critères optionnels, choix pour sélectionner entre 2 et 255 options avec probabilités normalisées, et score pour appliquer un barème ordonné à partir de 0 avec un score continu pondéré. La capacité annoncée va jusqu’à 1 000 questions en un passage.
Vous suivez la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Calibration annoncée et latence de 50–100 ms côté modèle
D’après Google, Gemini Decision 1 présente l’erreur de calibration la plus basse sur des jeux de tests dédiés au routage d’agents, au raisonnement, au classement et à la compréhension multimodale. L’analyse se fait sans passer par un décodage token par token, avec un temps de latence médian de 50 à 100 ms pour l’exécution du modèle et de 150 à 250 ms au total. Par ailleurs, la société indique que l’API Decisions, qui ne facture pas de tokens générés en sortie, coûte presque cinq fois moins que Gemini 3.5 Flash-Lite via l’API Interactions sur les benchmarks partagés.
Cas d’usage internes : routage, design, emojis et sécurité
Dans Gemini Notebook, l’API agit comme un routeur en temps réel pour orienter les requêtes vers le modèle adéquat. L’outil Stitch l’utilise pour produire en quelques secondes des prototypes interactifs d’un parcours produit. Dans CC, l’API choisit instantanément une réaction emoji parmi plus de 200 possibilités. Dans Search, elle fait office de couche de sécurité pour des outils MCP, avec détection de comportements et de contenus adverses.
Décisions probabilistes et économie d’usage
L’API vise la prise de décision rapide et probabiliste dans des contextes multimodaux, en fournissant des scores de confiance par question en un seul passage. Elle est présentée comme un moyen économique de traiter des requêtes, d’évaluer des contenus ou de vérifier des politiques. Les équipes peuvent démarrer immédiatement via Google AI Studio et s’appuyer sur la documentation Python, JavaScript et REST pour l’implémentation.