Perplexity publie deux modèles de décision à poids ouverts, Decider v1.3 et Flash, et introduit Locate pour extraire des segments de texte. L’éditeur communique des métriques de coût et de robustesse auto-rapportées, propose des tarifs API faibles et des options de déploiement local sous licence Apache 2.0.
Coûts et robustesse annoncés par Perplexity
Perplexity annonce un taux de changement de réponse de 0,27 % et un coût de 26,47 $ par million de requêtes de production pour Decider v1.3. Sur 1 million de requêtes et 2 318 887 questions, l’éditeur rapporte un accord de 93,98 % avec des juges LLM de pointe, contre 93,35 % pour Jev 1.14. La robustesse serait mesurée à 0,27 % de changements lors de transformations de réordonnancement ou de réétiquetage, là où Jev 1.14 varie entre 2,69 % et 4,84 %. Les coûts par million de requêtes sont aussi donnés à 13,24 $ pour Flash et 68,10 $ pour Jev 1.14. En récupération et réévaluation, Perplexity annonce un nDCG@10 de 83,99 sur 72 tâches, supérieur à Qwen3-Reranker-8B et Jev 1.14 selon les écarts publiés.
Locate extrait des spans et vise NER, PII et QA extractif
Locate permet d’extraire des segments textuels exacts, avec des décalages de caractères et des champs formulés en étiquette ou en instruction. Cette capacité concerne la reconnaissance d’entités nommées, l’identification d’informations personnelles et l’extraction de réponses à partir du texte. Sur le plan technique, un token <|locate|> est inséré pour chaque champ, une tête de segment équipée d’un adaptateur LoRA est entraînée, alors que la structure principale et la tête de décision demeurent inchangées ; l’adaptateur n’est pas fusionné afin de maintenir la précision des décisions. Pour 17 tâches hors domaine, Perplexity indique une moyenne de 69,0 pour v1.3 et 63,6 pour Flash ; Liquid d1 et GLiNER large v2.5 sont indiqués respectivement à 43,3 et 33,6. Perplexity précise que Flash reste derrière Jev 1.14 en finance, programmation et droit, et que les requêtes Locate acceptent jusqu’à 128 questions.
Architecture : un LLM génératif converti en classificateur
Decider adapte une architecture de modèle de langage génératif en classificateur : la tête de sortie, issue de la tête de langage, est réduite aux tokens d’option et une tête linéaire lit l’état caché au token <|marker|> pour produire des probabilités. Perplexity rapporte que le passage des couches d’attention complète en bidirectionnel s’est révélé bénéfique dans ses ablations. Dans la v1.3, la gestion de l’attention entre les questions évolue : l’état a accès à l’ensemble des questions, tandis que chaque question ne peut consulter que l’état et elle-même, le tout en un unique passage. L’apprentissage se fait en trois phases : d’abord un ajustement complet sur plusieurs centaines de jeux publics, suivi d’un entraînement d’un adaptateur LoRA pour la spécialisation, puis d’un autre pour la vision ; les poids sont ensuite moyennés sur trois graines et Flash est distillé en minimisant la divergence KL vis-à-vis du modèle principal. Cette famille, qui prend modèle sur Jev de TypeSafe, structure chaque requête autour d’un état partagé et de questions à choix, et la v1.3 succède aux versions 1.2, y compris pour Flash.
Vous voulez les meilleurs outils IA avant les autres ?
On teste et on décrypte les nouveaux outils IA chaque soir, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Spécifications, contraintes matérielles et latences
Decider v1.3 s’appuie sur Qwen3.8-27B et Flash sur Qwen3.5-4B, Hugging Face indiquant respectivement 26B et 5B de paramètres. L’entrée API est inférieure à 256K tokens, avec une valeur locale par défaut de 32 768. Côté matériel, v1.3 requiert environ 49 GiB de poids en BF16 contre 8,5 GiB pour Flash, sans variantes quantifiées proposées. Perplexity mesure une requête d’environ 243K tokens à 16 secondes pour v1.3 et 5 secondes pour Flash. En local, le chargement passe par Decider.from_pretrained() dans le package pplx_decider, avec des couches d’attention complète en mode non causal ; Perplexity recommande v1.3 pour des sujets nuancés et Flash pour un routage à fort volume.
Tarifs, accès API et positionnement face aux pairs
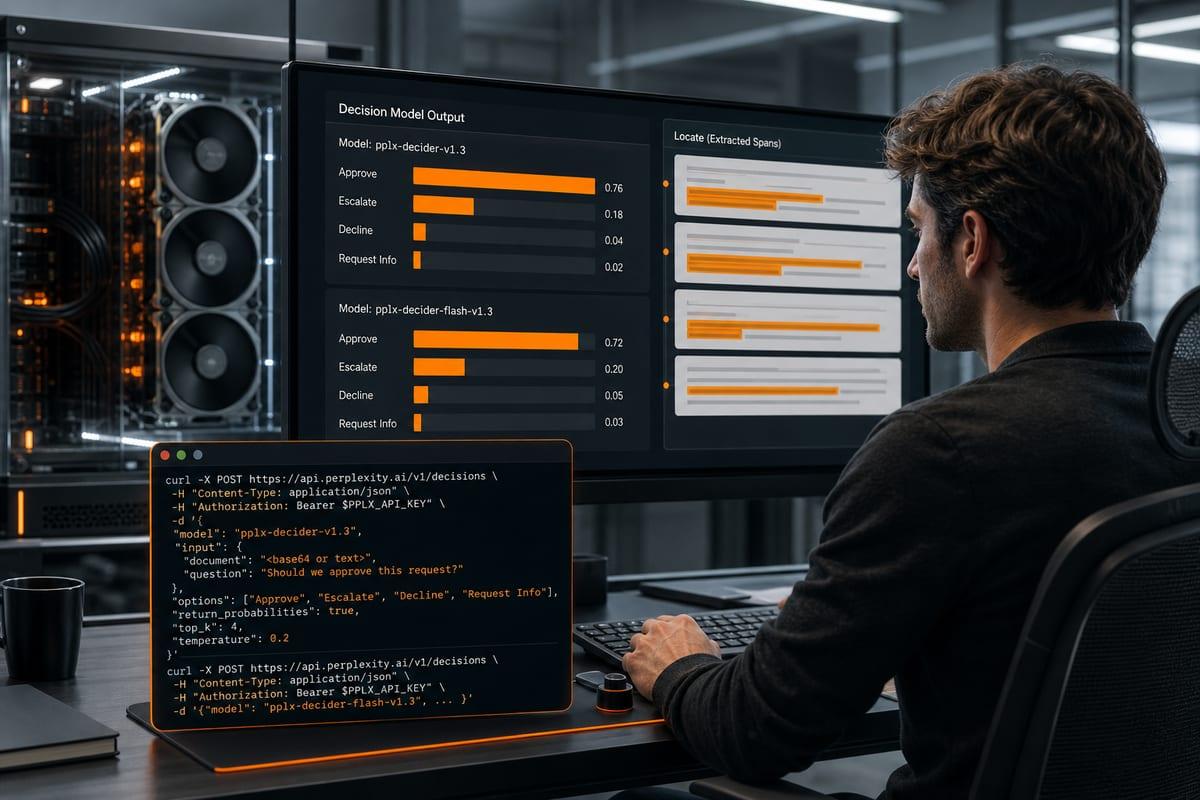
L’API Decisions est accessible via POST https://api.perplexity.ai/v1/decisions avec les identifiants pplx-decider-v1.3 et pplx-decider-flash-v1.3, et des alias -latest ; l’entrée est facturée 0,02 $ pour v1.3 et 0,01 $ pour Flash, la sortie étant gratuite. Les modèles sont également disponibles sur OpenRouter et leurs poids sous licence Apache 2.0 sur Hugging Face. Sur le plan des performances auto-rapportées, Perplexity revendique 91,6 % sur 63 tâches de classification de requêtes, 6,54 points au-dessus de classificateurs de production, et annonce devancer Jev 1.14 dans 7 domaines, jusqu’à 12,9 points en finance. En multilingue (19 tâches, 8 langues), Perplexity indique 88,16 % pour v1.3 et 86,50 % pour Flash, contre 85,41 % pour Jev 1.14 ; en classification d’images (5 tâches), 76,99 % pour v1.3, 1,47 point au-dessus de Jev 1.14, et 72,77 % pour Flash. Côté contexte et licences, Jev 1.14 est donné à 262 144 tokens de contexte, licence non divulguée et accès hébergé uniquement, tandis que Qwen3-Reranker-8B reste en poids ouverts et auto-hébergé ; Decider gère texte, images et Locate (texte uniquement), Jev 1.14 le texte et l’image, Qwen3-Reranker-8B le texte. En récupération, Perplexity publie 83,99 en nDCG@10, avec des valeurs dérivées annoncées de 81,75 pour Jev 1.14 et 82,18 pour Qwen3-Reranker-8B à partir des écarts fournis.