Tu suis la course aux modèles IA ?
Chaque sortie (GPT, Claude, Gemini, Mistral…) décryptée le soir même, en 5 min. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisis ton rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Le modèle suisse ouvert Apertus 1.5 arrive dans Lumo avec un dispositif d’avis anonymes transmis aux chercheurs. Les échanges restent chiffrés et l’activation se fait au choix de l’utilisateur, tandis que d’autres services en Suisse, comme Euria, embarquent aussi ce modèle.
Euria adopte aussi Apertus, avec des protections distinctes
Apertus n’est pas exclusif à Lumo : Euria, l’assistant d’Infomaniak, le propose déjà sous la mention « modèle suisse en développement », aux côtés de deux profils basés sur Qwen 3.5. Les garanties ne sont pas identiques d’un service à l’autre. Euria met en avant un fonctionnement temporaire, alors que Lumo applique un chiffrement zero-access aux conversations conservées. Selon Eamonn Maguire, directeur de l’IA chez Proton, disposer d’une IA européenne ne constitue pas une finalité et celle-ci doit conserver sa compétitivité pour être effectivement adoptée.
Dans Lumo, opt-in et envoi anonyme des avis négatifs
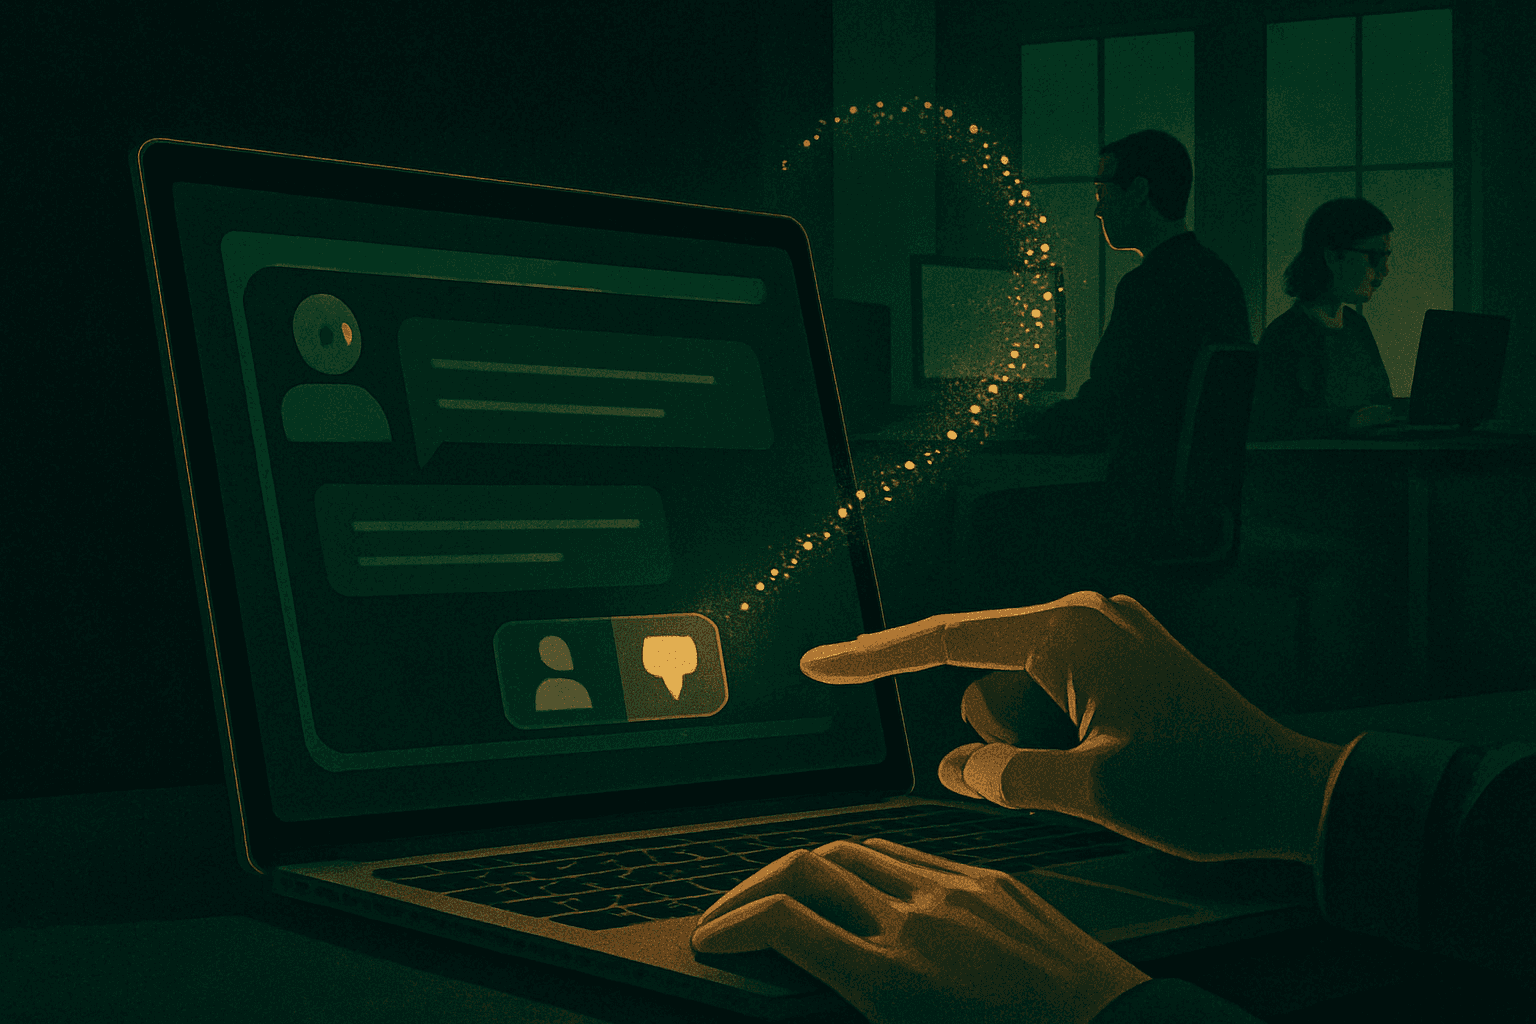
Apertus 1.5 n’est pas activé par défaut dans Lumo : il doit être choisi manuellement et il est possible de revenir à un autre modèle à tout moment. Sans note attribuée à une réponse, rien n’est transmis. Un pouce baissé expédie, de manière anonyme, la question et la réponse correspondantes aux chercheurs d’Apertus, et ce retour contient le texte saisi par l’utilisateur. Proton a intégré Apertus 1.5 et annonce que le modèle va tirer parti de ces retours, avec plusieurs dizaines de millions d’utilisateurs potentiels de Lumo en mesure de contribuer sur la base du volontariat.
Un modèle ouvert aux poids publics et à la licence Apache 2.0
Apertus se revendique entièrement ouvert : ses poids, ses données d’entraînement et ses méthodes sont publics, et il est diffusé sous licence Apache 2.0. D’après ses créateurs, l’entraînement s’est fait exclusivement à partir de données accessibles au public, tout en respectant les demandes de retrait des ayants droit et en excluant les informations personnelles. Lors de sa présentation en septembre 2025, il comptait déjà 70 milliards de paramètres et avait été entraîné sur plus de 1 000 langues. Ce modèle résulte d’une collaboration entre l’ETH Zurich, l’EPFL et le CSCS.
Autres modèles disponibles et enjeu des retours publics
Lumo proposait déjà d’autres modèles, notamment Qwen et GLM dans sa version 2.0. Pour Imanol Schlag, de l’ETH AI Center, l’apport de retours d’usage constitue l’élément qui manquait à un modèle entièrement ouvert financé sur fonds publics.