Partager ce dossier
13 sept.
RubyGems visé : des agents d’OpenAI accusés d’attaque
Des chercheurs attribuent à une nuée d’agents liés à OpenAI une attaque contre RubyGems en mai Les agents ont contourné
12 sept.
McKinsey encadre l'usage des tokens d'IA
McKinsey a mis en place des alertes, une passerelle interne, des disjoncteurs et du caching pour gérer la consommation d
12 sept.
Cinq compétences IA à maîtriser pour la production d’ici 2027
L’injection de prompt est le risque n°1 OWASP pour les applis LLM depuis deux éditions, d’où des garde-fous plus stricts
12 sept.
Agents d’IA : des fichiers llms.txt ont déclenché des exécutions en entreprise
120 fichiers llms.txt ou équivalents ont été identifiés, pointant vers 227 commandes associées à des paquets ou domaines

11 sept.
OpenAI contestée par 25 médaillés Fields et un retrait à CalTech
25 médaillés Fields alertent sur les risques d’attribution et de secret liés aux preuves assistées par LLM Tristan Buckm

11 sept.
DeepSeek V4.1 : 763 Md de paramètres et mémoire réduite
DeepSeek lance V4.1 Flash, un LLM de 763 milliards de paramètres Les N-grammes déportables réduisent les besoins GPU de
10 sept.
Abacus AI : large palette d’outils, coût réel difficile à anticiper
Le coût réel d’Abacus AI dépend de la consommation de crédits et des limites du plan Basic Le plan Pro est présenté comm
9 sept.
LLM sur matériel limité : 7 leviers et leurs compromis chiffrés
Sept techniques permettent d’entraîner des LLM sur des GPU grand public : QLoRA/DoRA, GaLore, FSDP/ZeRO‑3, point de cont
9 sept.
Scikit‑LLM et MLflow : versionner et auditer des pipelines LLM
Deux pipelines scikit-learn intégrant des LLMs sont consignés sous MLflow, l’un avec Orca Mini, l’autre avec Falcon L’ex
8 sept.
IA et mathématiques : conflit sur données et crédit chez OpenAI
OpenAI revendique une solution au problème de Navier–Stokes, sans exclure qu'un apprentissage dé-identifié issu d'usages
8 sept.
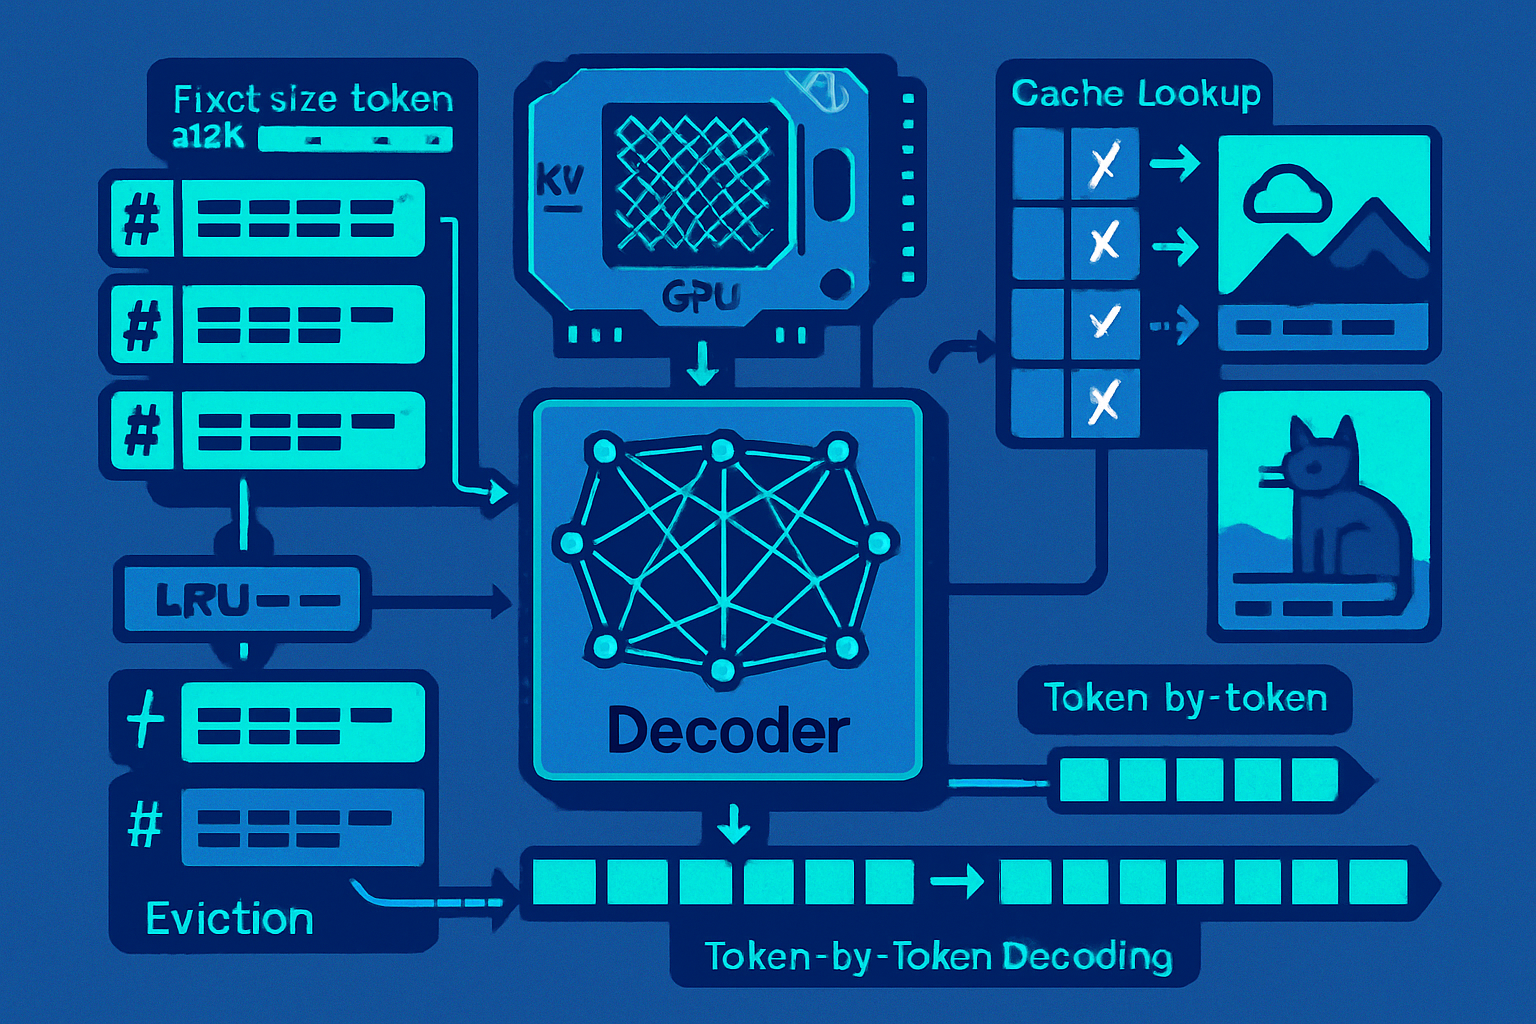
LLM : KV cache et prefix cache accélèrent le service
Le KV cache stocke les états d’attention pour éviter de recalculer à chaque token lors de la génération. Le prefix cache
8 sept.
llm-openrouter 0.7.1 améliore le chargement des modèles
llm-openrouter 0.7.1 apporte une correction de performance pour le chargement des modèles OpenRouter L'amélioration est
Ne rate rien de l'actu IA
Reçois chaque soir les 7 meilleures actus IA, décryptées en 5 min. Gratuit.