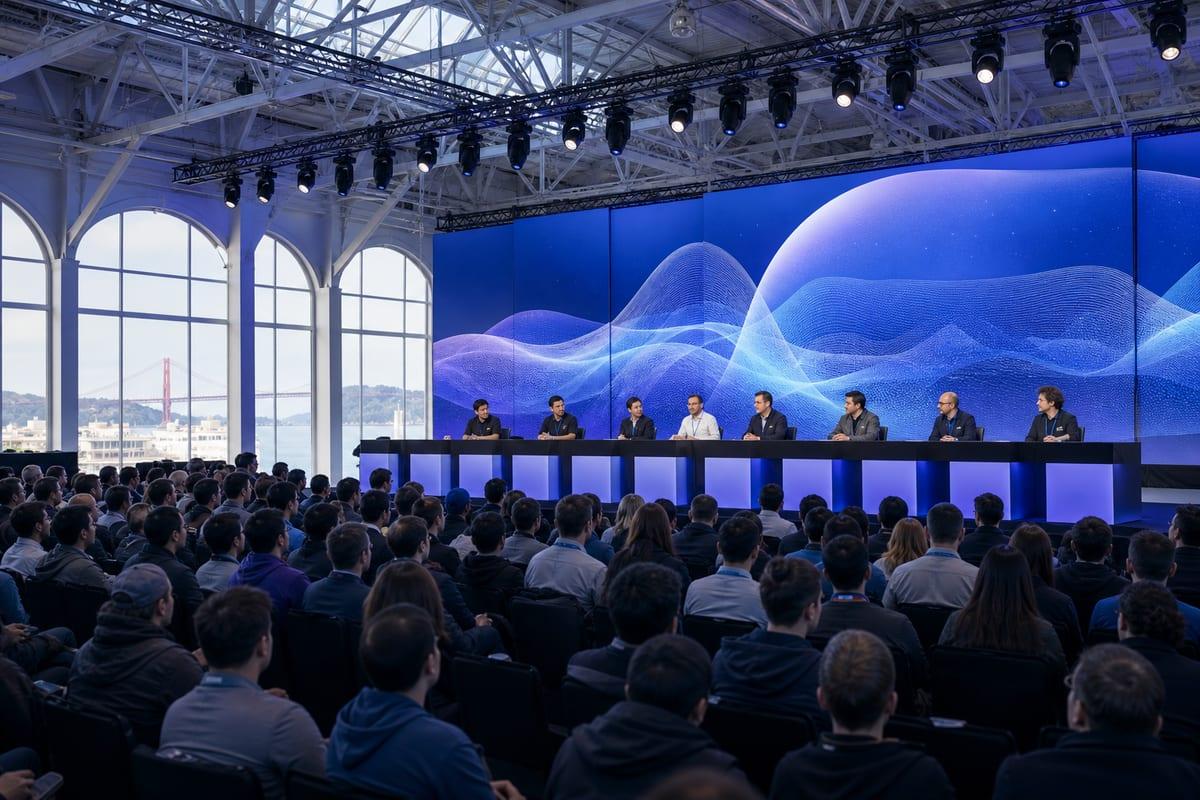
LMSYS Org réunit des acteurs majeurs des puces et de l’infrastructure autour du Consortium SGLang, annoncé au SGLang Summit à San Francisco. La structure définit un cadre de travail commun pour l’inférence open-source, à l’heure où cette phase du cycle IA prend une place croissante dans la dépense de calcul.
Un sommet dédié réunit plus de 100 intervenants à San Francisco
Le SGLang Summit, première conférence consacrée à SGLang et à sa communauté open-source, s’est tenu les 12 et 13 novembre au Fort Mason Center for Arts & Culture à San Francisco. Plus de 100 intervenants venus du matériel IA, des modèles, de l’infrastructure et des applications y participent, avec des sessions couvrant l’apprentissage par renforcement, les modèles multimodaux et les plateformes matérielles. SGLang, déjà utilisé dans certaines des plus grandes mises en production d’inférence au monde et déployé sur des centaines de milliers de GPU, sert de socle commun à ces échanges.
Un cadre de travail partagé et des chantiers techniques ciblés
Le consortium offre à ses membres un forum permanent pour dialoguer avec les mainteneurs de SGLang et transformer des priorités communes en travaux d’ingénierie. Les thématiques présentées incluent la prise en charge des modèles avancés, le développement du raisonnement, la gestion des charges multimodales, l’inférence distribuée ainsi que l’optimisation du matériel. Chaque membre fondateur nommera un référent technique et sera présent à deux réunions annuelles sur la feuille de route, avec la possibilité d’apporter son expertise, des retours sur les déploiements, des moyens de test ou des développements partagés. Des groupes de travail pourront se réunir entre ces rencontres et des actualisations publiques informeront sur l’évolution et les avancées. Les mainteneurs de SGLang gardent la main sur les choix techniques et l’intégration du code, et l’ensemble du projet demeure accessible à toute la communauté.
La recherche en IA vous passionne ?
Les papers et avancées qui comptent, expliqués simplement, chaque soir. Gratuit.
Inclus dès l'inscription : notre sélection des meilleurs guides & comparatifs IA.
Choisissez votre rythme
Gratuit · Pas de spam · Désabonnement en 1 clic
Des fondateurs de NVIDIA à Google, et des prises de position affirmées
Le Consortium SGLang réunit comme membres fondateurs NVIDIA, AMD, Intel, Google, Meta, Cloudflare, Modal et RadixArk. NVIDIA, par la voix d’Ian Buck, exprime sa volonté de faire avancer les logiciels d’inférence ouverts, estimant qu’un meilleur logiciel augmente les performances tirées de ses calculs, que des modèles ouverts favorisent de nouvelles applications et entreprises, et que la baisse des coûts d’inférence rend l’IA plus accessible. Ying Sheng met en avant que l’exploitation de SGLang à une échelle massive permet de mieux prévoir les besoins liés à l’inférence et que, face aux obstacles à la création de nouveaux centres de données, l’amélioration de l’efficacité par le logiciel sera essentielle pour les utilisateurs de SGLang et l’ensemble de l’écosystème. Du côté des acteurs, RadixArk, société fondée par Ying Sheng et Banghua Zhu, regroupe les principaux créateurs et mainteneurs de SGLang et Miles, et propose une infrastructure gérée ainsi que des outils pour l’inférence et l’entraînement. LMSYS Org, organisation à but non lucratif à l’origine de SGLang, pilote également des projets ouverts et évolutifs tels que FastChat, Vicuna et Chatbot Arena, avec des ressources disponibles sur lmsys.org et sglang.io.
L’inférence prend du poids et SGLang s’inscrit dans PyTorch
D’après Deloitte, la part de l’inférence dans la puissance de calcul consacrée à l’IA devrait atteindre environ deux tiers d’ici 2026, alors qu’elle représente environ la moitié en 2025. Ainsi, le moteur d’inférence a un impact direct sur la vitesse et le coût des traitements réalisés sur les infrastructures en place. SGLang, intégré à l’écosystème PyTorch, fonctionne à l’échelle de centaines de milliers de GPU et alimente de vastes déploiements en production chez plusieurs grands acteurs. C’est dans ce cadre que la création du consortium a été annoncée, lors de la keynote d’ouverture du premier SGLang Summit.